Bagaimana Menggunakan Model Naive Bayes untuk Menjawab Pertanyaan Market Riset dan Bisnis?
Tadi pagi, saya kebagian jatah sharing di LEFO (learning forum internal tim Market Research di Nutrifood). Topiknya kelihatan “berat” dengan judul: Peluang Bersyarat dan Naive Bayes. Sebenarnya, disadari atau tidak, topik ini adalah pekerjaan setiap hari dari tim market riset.
Saya harap tulisan ini bisa jadi referensi buat rekan-rekan yang penasaran dan mau belajar ulang tentang peluang bersyarat.
Pertanyaan Market Riset itu Sebenarnya Pertanyaan Probabilitas
Coba perhatikan pertanyaan-pertanyaan yang biasa muncul di meja kerja tim market riset:
- “Apakah orang yang lihat iklan cenderung beli produk?”
- “Segmen mana yang paling mungkin jadi pelanggan setia?”
- “Kalau konsumen sudah pakai kompetitor, apa masih mau coba brand kita?”
Semua pertanyaan itu, kalau ditelaah lebih lanjut, punya bentuk yang persis sama:
“Berapa peluang A, kalau kita sudah tahu B terjadi?”
Itulah peluang bersyarat dan ternyata dialah fondasi dari hampir semua analisis market riset yang kami kerjakan sehari-hari, entah disadari atau tidak.
Peluang Bersyarat: Definisi dan Intuisinya
Secara formal, peluang bersyarat didefinisikan sebagai:
P(A|B) = P(A ∩ B) / P(B)
Dibaca “peluang A, jika diberi B”. Intuisinya sederhana: ruang kemungkinan kita dipersempit. Dari semula “semua orang”, menjadi “hanya mereka yang memenuhi syarat B”. Baru di dalam ruang yang lebih kecil itu kita hitung proporsi terjadinya kejadian A.
Biar tidak abstrak, mari pakai contoh nyata: 100 responden disurvei soal apakah mereka aware iklan dan apakah mereka jadi user brand tertentu.
| User = Ya | User = Tidak | Total | |
|---|---|---|---|
| Aware = Ya | 30 | 20 | 50 |
| Aware = Tidak | 15 | 35 | 50 |
| Total | 45 | 55 | 100 |
Tanpa syarat apa pun, peluang seseorang jadi user cuma P(User) = 45/100 = 45%. Tapi begitu kita syaratkan “orang itu sudah aware iklan”, peluangnya berubah jadi:
P(User | Aware) = 30 / 50 = 60%
| Peluangnya naik dari 45% ke 60%. Selisih inilah yang membuat peluang bersyarat berguna. Analisa ini mengukur informasi tambahan yang dibawa oleh syarat B. Kalau syarat B tidak membawa informasi apa-apa, P(A | B) akan sama saja dengan P(A). |
Tabel di atas sering disebut sebagai analisa crosstabulasi bagi kami di market riset.
Dari Peluang Bersyarat Menuju Teorema Bayes
Sekarang, perhatikan bahwa peluang bersyarat bisa dihitung dari dua arah:
P(A|B) = P(A ∩ B) / P(B) dan P(B|A) = P(A ∩ B) / P(A)
Keduanya berbagi pembilang yang sama, P(A ∩ B). Karena itu kita bisa saling mensubstitusi:
P(A ∩ B) = P(A|B)·P(B) = P(B|A)·P(A)
Susun ulang persamaan ini, dan lahirlah Teorema Bayes:
P(A|B) = [P(B|A) · P(A)] / P(B)
Rumus ini kelihatan sederhana, tapi maknanya besar: Bayes membiarkan kita membalik arah peluang bersyarat dari P(B|A) yang kita tahu (atau bisa kita hitung dari data), ke P(A|B) yang sebenarnya ingin kita ketahui.
Tiap komponen di rumus itu punya nama sendiri, dan nama-nama ini akan terus muncul sepanjang tulisan:
| Komponen | Simbol | Arti | |
|---|---|---|---|
| Posterior | P(A | B) | Keyakinan setelah melihat bukti B — inilah yang kita cari |
| Likelihood | P(B | A) | Seberapa mungkin bukti B muncul, jika A benar |
| Prior | P(A) | Keyakinan awal tentang A, sebelum melihat bukti apa pun | |
| Evidence | P(B) | Peluang total munculnya bukti B, berfungsi sebagai penormal |
Ringkasnya: Posterior ∝ Likelihood × Prior.
Khusus untuk pembahasan terkait Bayes, saya sudah menuliskan beberapa tulisan terkait Bayes.
Naive Bayes: Apa Itu, dan Kenapa “Naif”?
Naive Bayes adalah algoritma klasifikasi probabilistik yang dibangun langsung di atas Teorema Bayes. Cara kerjanya:
- Setiap prediktor (fitur) dianggap memberi bukti tentang kelas target.
- Model menghitung peluang tiap kelas, diberi semua bukti yang ada. Persis konsep peluang bersyarat yang barusan kita bahas.
- Kelas dengan peluang posterior tertinggi yang dipilih sebagai prediksi.
Lalu kenapa namanya pakai embel-embel “naive” (naif)? Karena model ini mengasumsikan semua fitur saling independen, diberi kelasnya. Ini asumsi yang jarang 100% benar di dunia nyata, tapi anehnya, terbukti bekerja sangat baik secara praktis, terutama untuk data kategorik. Kesederhanaan itu justru jadi kekuatannya.
Naive Bayes vs Model Machine Learning Lain
Supaya lebih terbayang posisinya, saya coba bandingkan dengan dua model klasifikasi populer lain:
| Naive Bayes | Logistic Regression | Decision Tree / Random Forest | |
|---|---|---|---|
| Dasar perhitungan | Peluang bersyarat (Bayes) | Fungsi logit linear | Aturan pemisahan (split) berulang |
| Asumsi antar fitur | Independen, diberi kelas | Tidak perlu independen | Tidak perlu independen |
| Cocok untuk data kategorik | Sangat cocok (native) | Perlu encoding | Perlu encoding |
| Kebutuhan data | Kecil pun cukup | Sedang | Cenderung besar |
| Interpretasi | Langsung berupa peluang per kategori | Koefisien linear | Butuh feature importance |
| Kecepatan training | Sangat cepat | Cepat | Lebih lambat |
Contoh Kasus Termasyhur: Filter Spam Email
Kalau ada satu aplikasi Naive Bayes yang paling mendunia, itu adalah filter spam email. Sejak akhir 1990-an, penyedia email (Outlook, lalu Gmail) memakainya untuk memutuskan: email ini spam atau bukan?
- Fitur (X): kemunculan kata-kata tertentu di badan email. Misalnya “gratis”, “menang”, “klik di sini”.
- Kelas (Y): Spam vs bukan spam
- Model belajar dari ribuan email berlabel: seberapa sering tiap kata muncul di email spam dibanding yang bukan spam.
P(Spam|kata₁,…,kataₙ) ∝ P(Spam) · ∏ᵢ P(kataᵢ|Spam)
Alasannya sederhana: fiturnya berupa kategorik dengan isinya biner (kata tersebut muncul atau tidak) dan jumlahnya sangat banyak. Naive Bayes tetap cepat dan cukup akurat, meskipun asumsi independensi antar kata itu jelas-jelas dilanggar. Kata-kata dalam kalimat pasti saling berkaitan. Tapi ya itu tadi: “naif” tidak berarti “buruk”.
Pada 2018, saya pernah menuliskan artikel terkait penggunaan Naive Bayes untuk menebak siapa pengirim pesan di WhatsApp saya.
Kenapa Cocok untuk Data Survey Berbentuk Kategorik?
Ini bagian yang paling relevan buat pekerjaan sehari-hari saya. Data survey riset pasar biasanya berbentuk jawaban Ya/Tidak, skala Likert, atau pilihan ganda. Semuanya kategorik, bukan angka kontinu.
| Aware A | Aware B | User X |
|---|---|---|
| Ya | Tidak | Ya |
| Tidak | Ya | Tidak |
Untuk fitur kategorik seperti ini, P(Xᵢ|Y) tinggal dihitung dari tabel frekuensi. Tidak perlu ada asumsi distribusi rumit seperti pada model berbasis jarak atau angka kontinu. Itu sebabnya Naive Bayes jadi pintu masuk paling alami buat tim market riset yang datanya dominan survey kategorik.
Studi Kasus: Simulasi Data Survey Media Habit
Sekarang masuk ke praktik. Saya simulasikan 200 responden dummy: empat pertanyaan awareness iklan di platform A, B, C, dan D. Lalu ada satu pertanyaan terkait status user dari Brand X.
Berikut adalah sampel enam baris data pertama:
| # | Aware A | Aware B | Aware C | Aware D | User X |
|---|---|---|---|---|---|
| 1 | Tidak | Tidak | Ya | Tidak | Tidak |
| 2 | Ya | Ya | Tidak | Tidak | Ya |
| 3 | Tidak | Tidak | Ya | Tidak | Ya |
| 4 | Ya | Tidak | Tidak | Tidak | Ya |
| 5 | Ya | Tidak | Tidak | Tidak | Ya |
| 6 | Tidak | Ya | Tidak | Ya | Tidak |
Dari 200 responden, saya bisa menghitung:
- Sebanyak 89 orang (44.5%) aware iklan di platform A.
- Sebanyak 68 orang (34.0%) aware iklan di platform B.
- Sebanyak 61 orang (30.5%) aware iklan di platform C.
- Sebanyak 53 orang (26.5%) aware iklan di platform D.
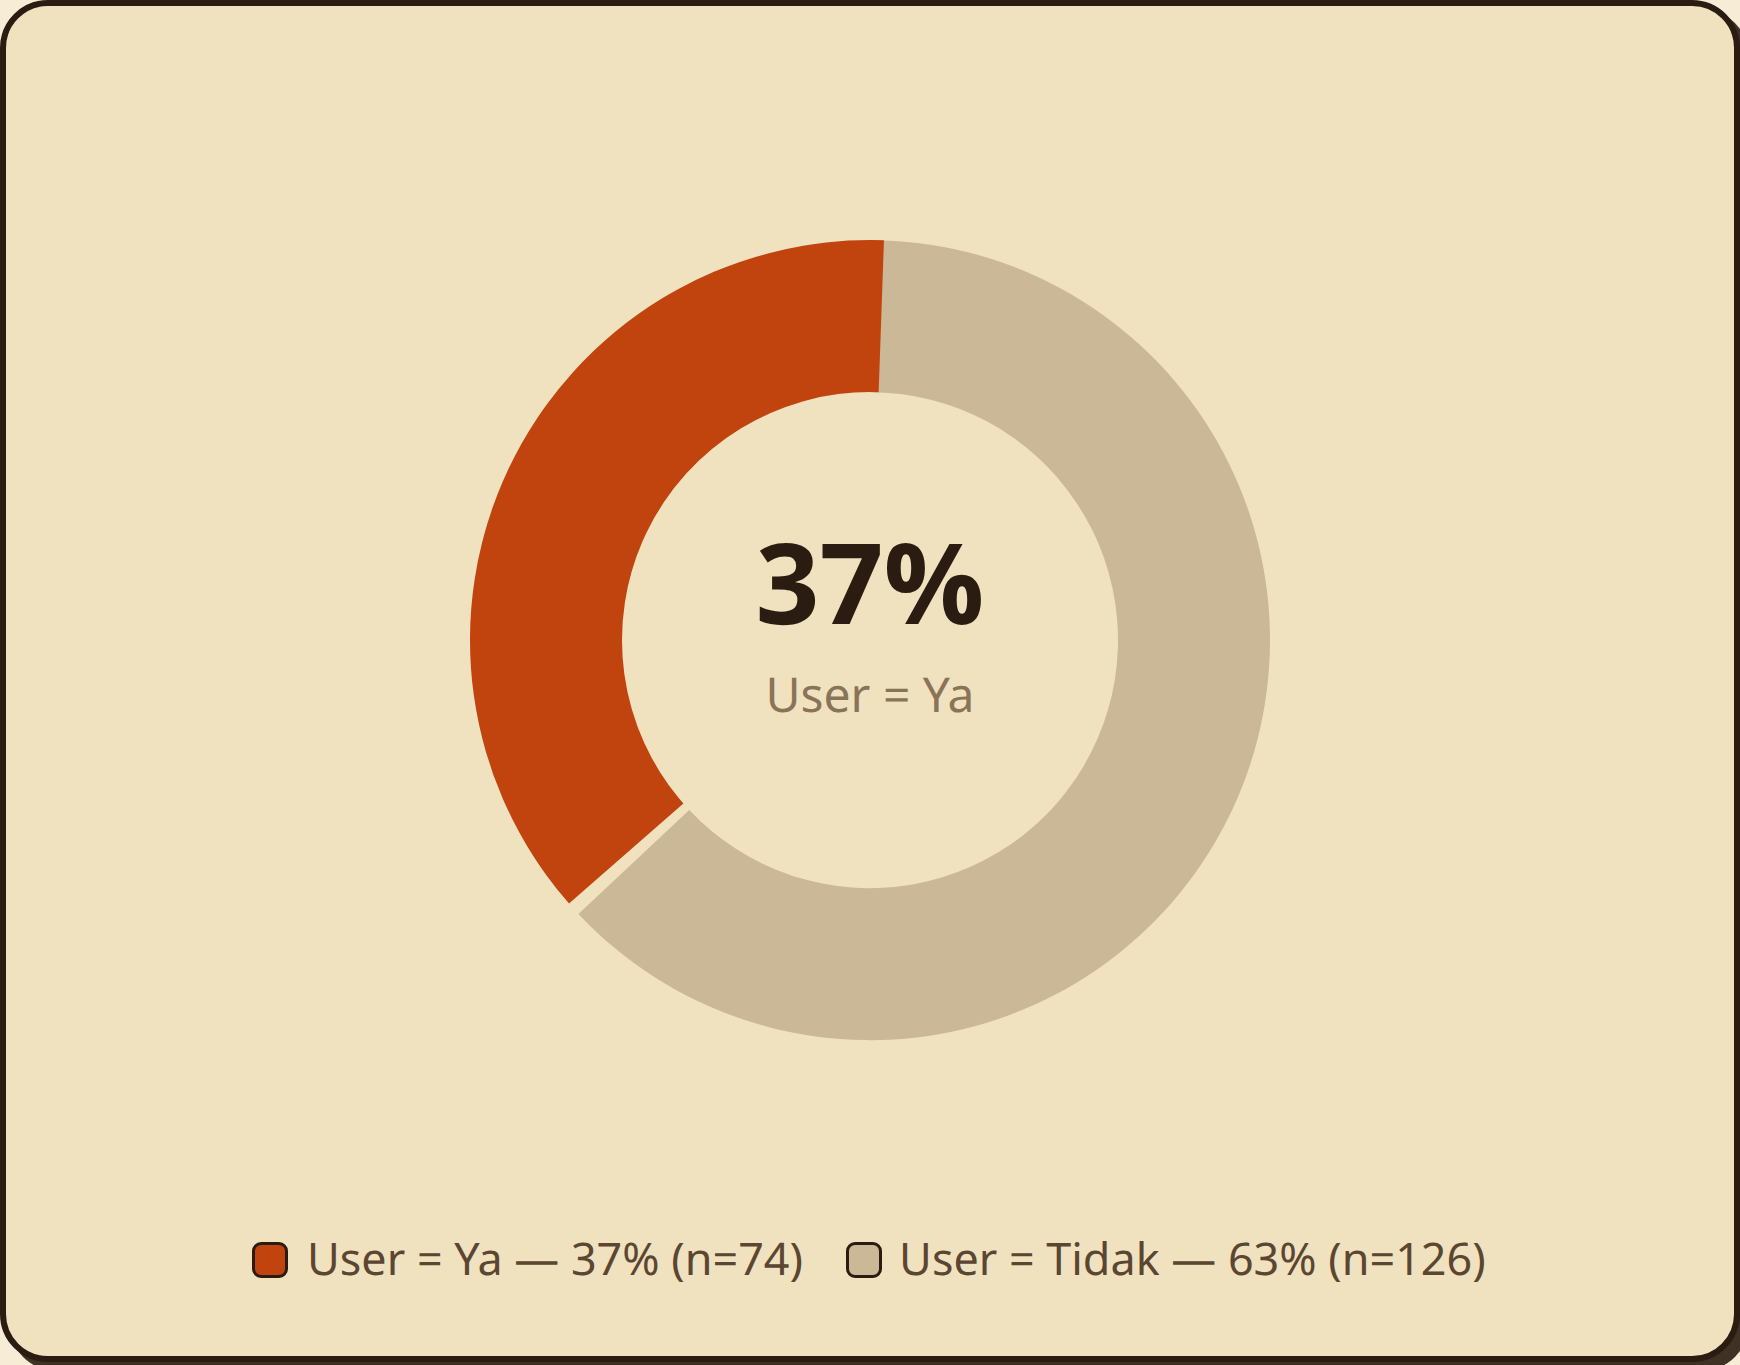
- Sebanyak 74 orang (37.0%) merupakan user dari brand X. Angka 37% ini nanti akan jadi prior kita. Titik awal sebelum kita masukkan informasi awareness iklan apa pun.
Supaya lebih kerasa gambarannya, saya buat upset diagram untuk melihat kombinasi awareness mana yang paling umum terjadi (upset diagram ini semacam versi yang lebih terbaca dari Venn diagram kalau variabelnya lebih dari 3):
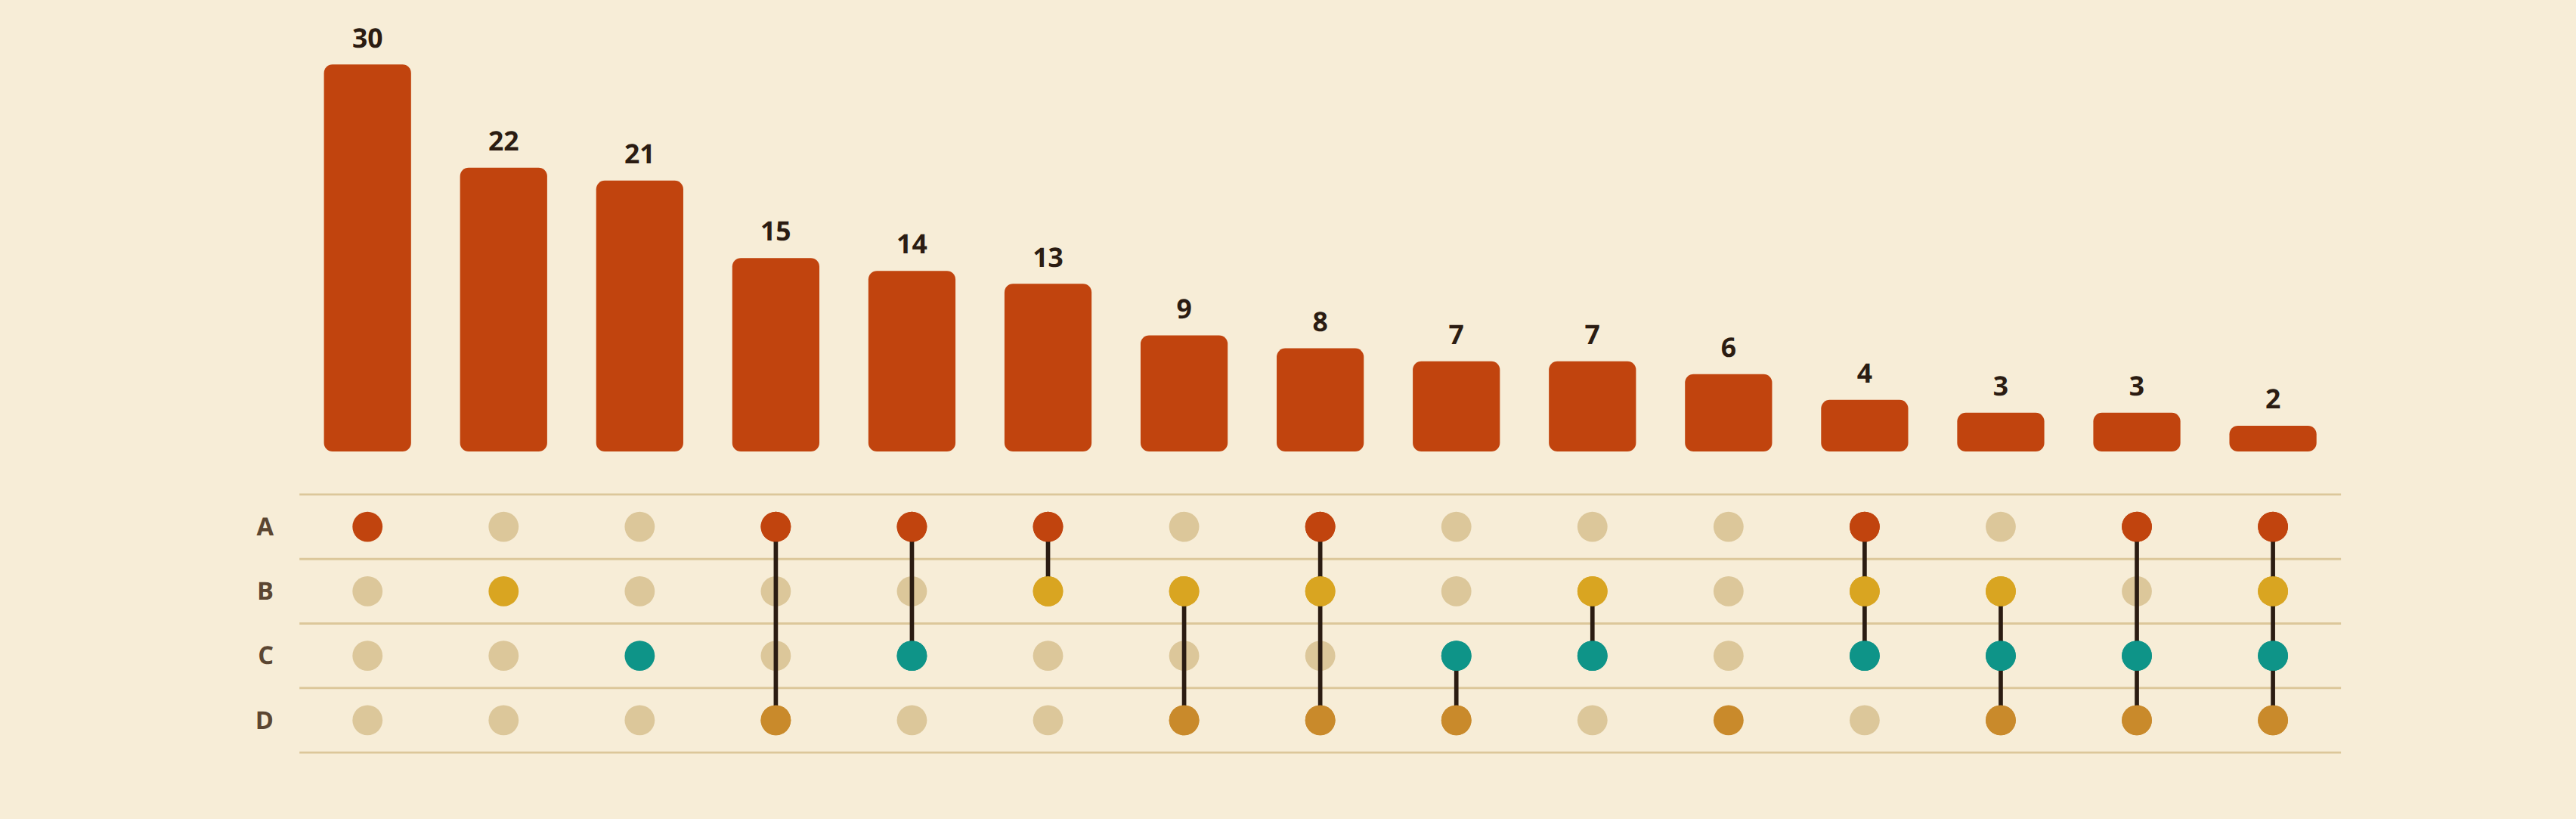
36 responden (18%) yang tidak aware iklan di platform mana pun tidak akan terlihat pada visualisasi di atas. Kombinasi paling umum: aware Platform A saja (30 orang), diikuti B saja (22 orang) dan C saja (21 orang).
Lima Pertanyaan Bisnis yang Ingin Kita Jawab dari Survey Tersebut
Dengan data ini di tangan, saya punya lima pertanyaan bisnis yang muncul di rapat tim marketing:
- Faktor (platform) apa yang paling menentukan seseorang responden menjadi user?
- Apakah orang yang terpapar iklan di lebih banyak platform makin mungkin jadi user?
- Jika seseorang sudah aware di Platform A, platform apa lagi yang paling efektif untuk mengonversi dia jadi user?
- Dari semua kemungkinan pasangan dua platforms, kombinasi mana yang paling optimal secara keseluruhan?
- Apakah menambah platform terus worth it, atau kenaikan peluangnya sudah diminishing returns?
| Semua pertanyaan ini pada dasarnya bertanya **“P(User | kondisi tertentu)”** dan hanya bisa dijawab dengan peluang bersyarat dan/atau Naive Bayes. |
Menariknya, saya sengaja menjawab kelima pertanyaan ini dua kali: pertama dengan cara manual (dplyr biasa, tanpa model apa pun), lalu dengan satu model Naive Bayes. Tujuannya supaya kita bisa lihat sendiri: kapan cara manual “cukup”, dan apa sebenarnya nilai tambah dari sebuah model.
Babak 1: Menjawab Manual Langsung dari Data
Alur kerja cara manual sederhana saja dan diulang lima kali dengan filter/grouping yang berbeda-beda:
- Data Prep — bersihkan & ubah jawaban Ya/Tidak jadi faktor kategorik.
- Filter / Group Data — saring & kelompokkan 200 responden sesuai kondisi tiap pertanyaan (beda per Q).
- Hitung Proporsi —
mean(user_x=="Ya")pada tiap kelompok/filter. - Interpretasi Bisnis — bandingkan proporsi antar kelompok, baca kesimpulannya.
Semua dihitung langsung dari 200 data survey, tanpa model apa pun.
Q1 — Faktor Apa yang Paling Menentukan Jadi User?
Caranya: ubah data ke format panjang (pivot_longer semua kolom aware_*), filter yang aware == "Ya" (apa pun platform lainnya), lalu hitung proporsi user per platform.
survey |>
  pivot_longer(starts_with("aware_"),
     names_to="platform", values_to="aware") |>
  filter(aware=="Ya") |>
  summarise(p_user=round(mean(user_x=="Ya")*100,1),
            .by=platform) |> arrange(platform)
# A tibble: 4 × 2
  platform p_user
  <chr>     <dbl>
1 aware_a    43.8
2 aware_b    41.2
3 aware_c    52.5
4 aware_d    41.5
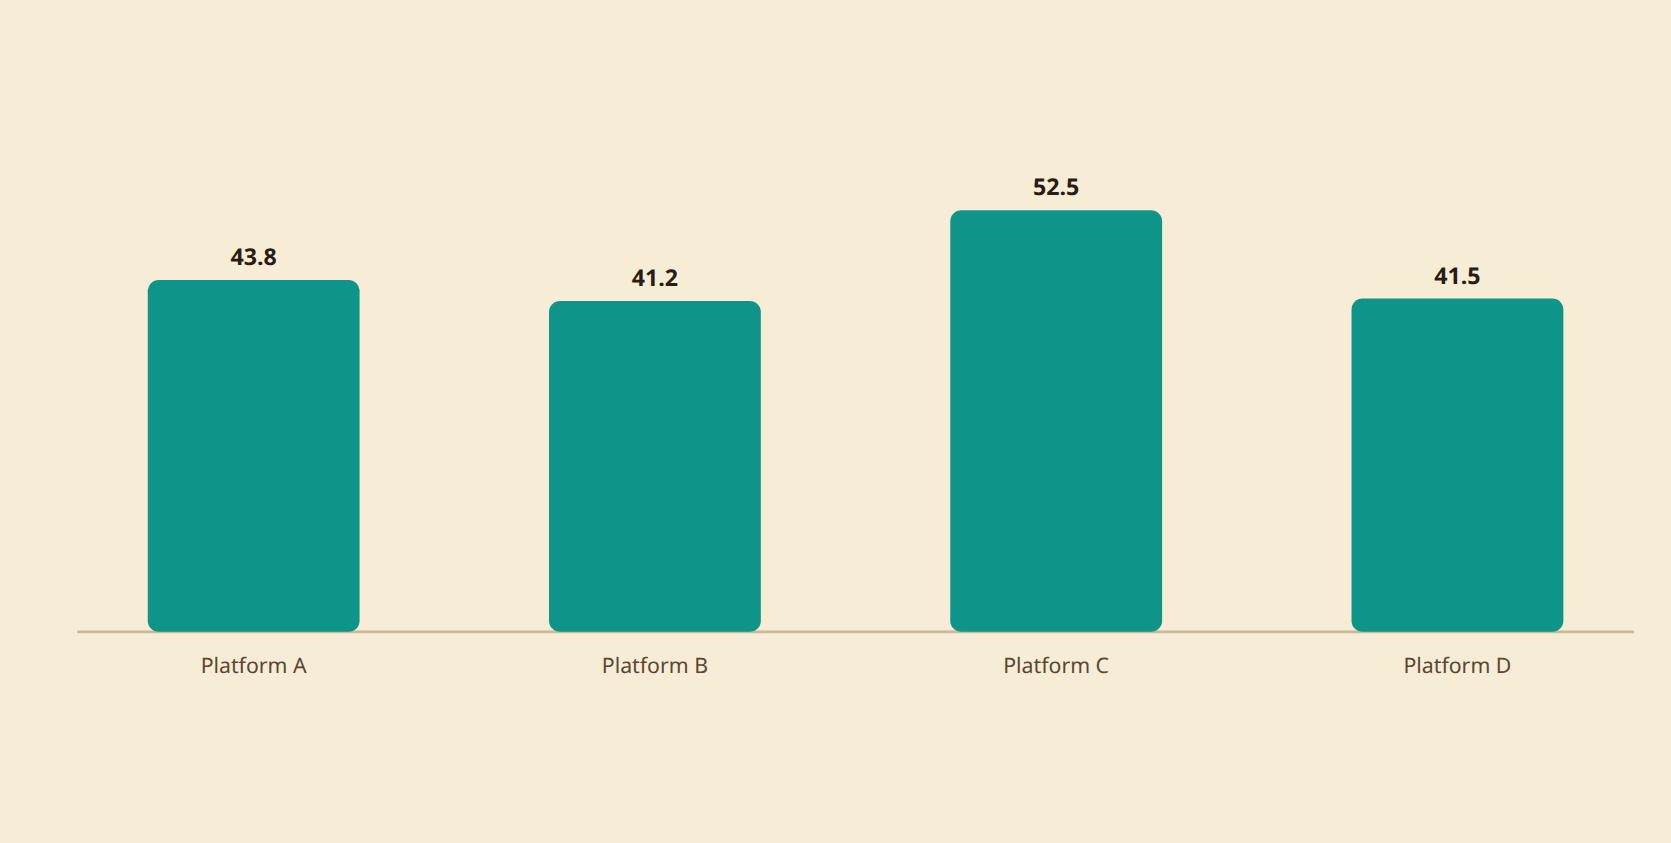
Platform C paling berpengaruh: 52.5% dari responden yang aware Platform C menjadi user — tertinggi dibanding A (43.8%), B (41.2%), dan D (41.5%). Urutannya: C > A > B ≈ D. (Ingat bobot logit yang saya set di awal? C memang saya kasih bobot terbesar — data “menemukan” itu kembali.)
Catatan penting: segmen di atas tidak eksklusif — responden yang aware A & C sekaligus dihitung di kedua kelompok.
Q2 — Apakah Makin Banyak Platform, Makin Mungkin Jadi User?
Kali ini saya hitung n_aware, yaitu jumlah platform yang di-aware tiap responden (0 sampai 4), lalu bandingkan proporsi user antar kelompok.
survey |>
  mutate(n_aware=rowSums(across(
    starts_with("aware_"), ~.x=="Ya"))) |>
  summarise(p_user=round(mean(user_x=="Ya")*100,1),
            .by=n_aware) |> arrange(n_aware)
# A tibble: 5 × 2
  n_aware p_user
    <dbl>  <dbl>
1       0   22.2
2       1   31.6
3       2   44.6
4       3   55.6
5       4  100
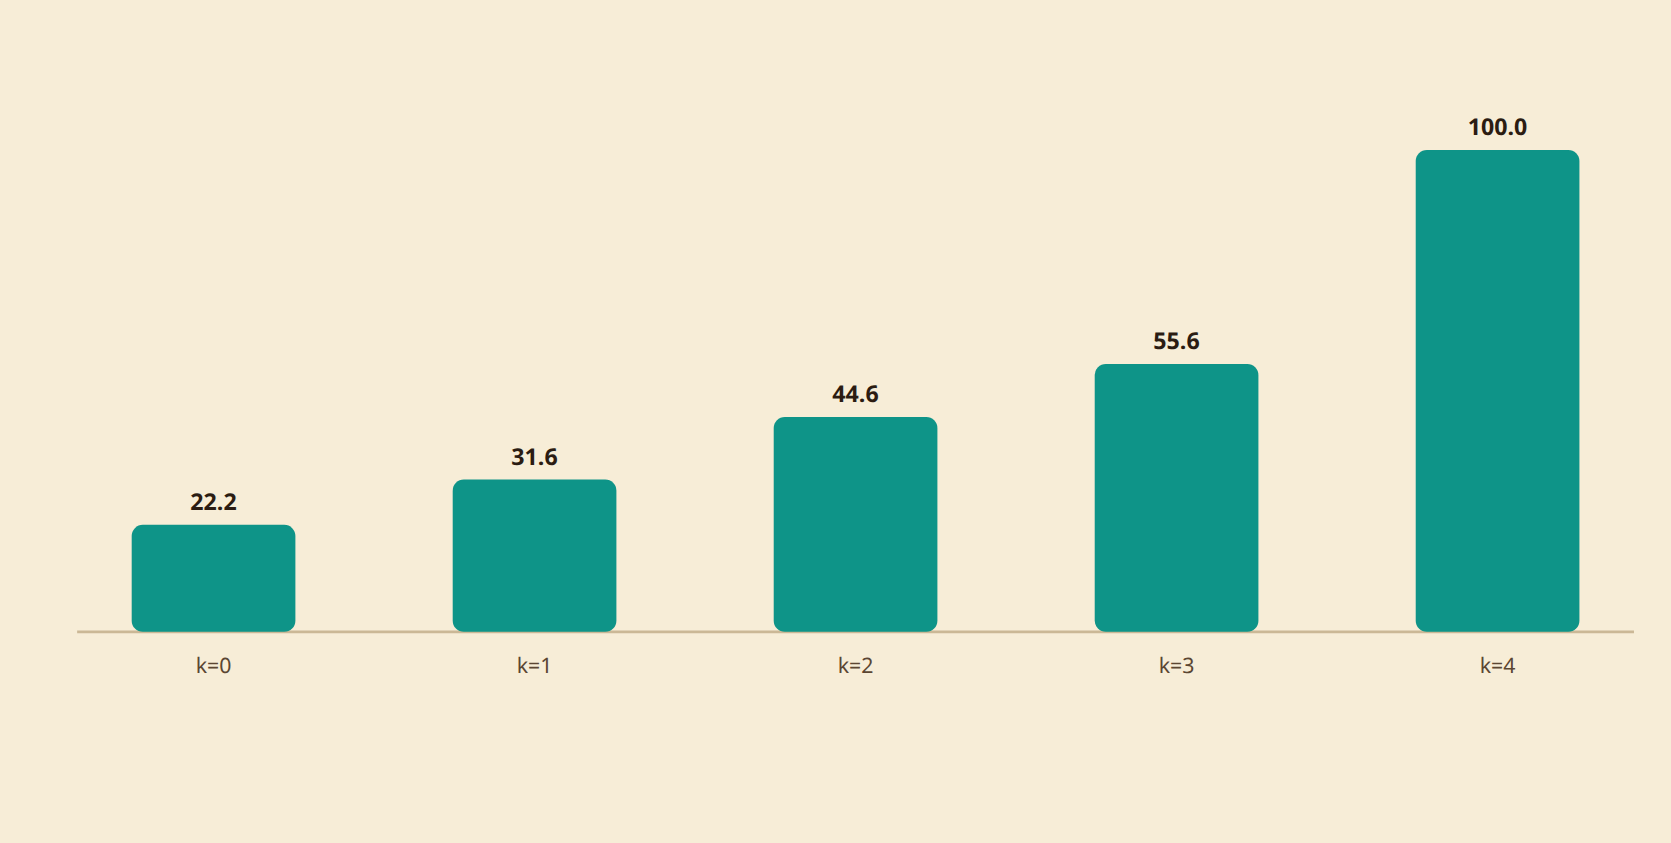
Makin banyak platform, makin tinggi peluangnya: 22.2% (n_aware=0) naik bertahap ke 55.6% (n_aware=3). Tapi hati-hati dengan angka 100% di n_aware=4 — kelompok ini cuma berisi 2 responden, jadi kurang bisa dipercaya begitu saja.
Q3 — Kalau Sudah Aware A, Platform Apa Lagi yang Paling Efektif?
Di sini saya bikin baseline (responden yang aware_a=="Ya"), lalu bandingkan dengan tambahan aware B, C, atau D.
base <- survey |> filter(aware_a=="Ya")
tambahan <- base |>
  pivot_longer(c(aware_b,aware_c,aware_d),
     names_to="kombinasi",values_to="aware") |>
  filter(aware=="Ya") |>
  summarise(p_user=round(mean(user_x=="Ya")*100,1),
            .by=kombinasi) |> arrange(kombinasi)
bind_rows(tibble(kombinasi="Baseline (A)",
    p_user=round(mean(base$user_x=="Ya")*100,1)), tambahan)
# A tibble: 4 × 2
  kombinasi    p_user
  <chr>         <dbl>
1 Baseline (A)   43.8
2 aware_b        51.9
3 aware_c        69.6
4 aware_d        42.9
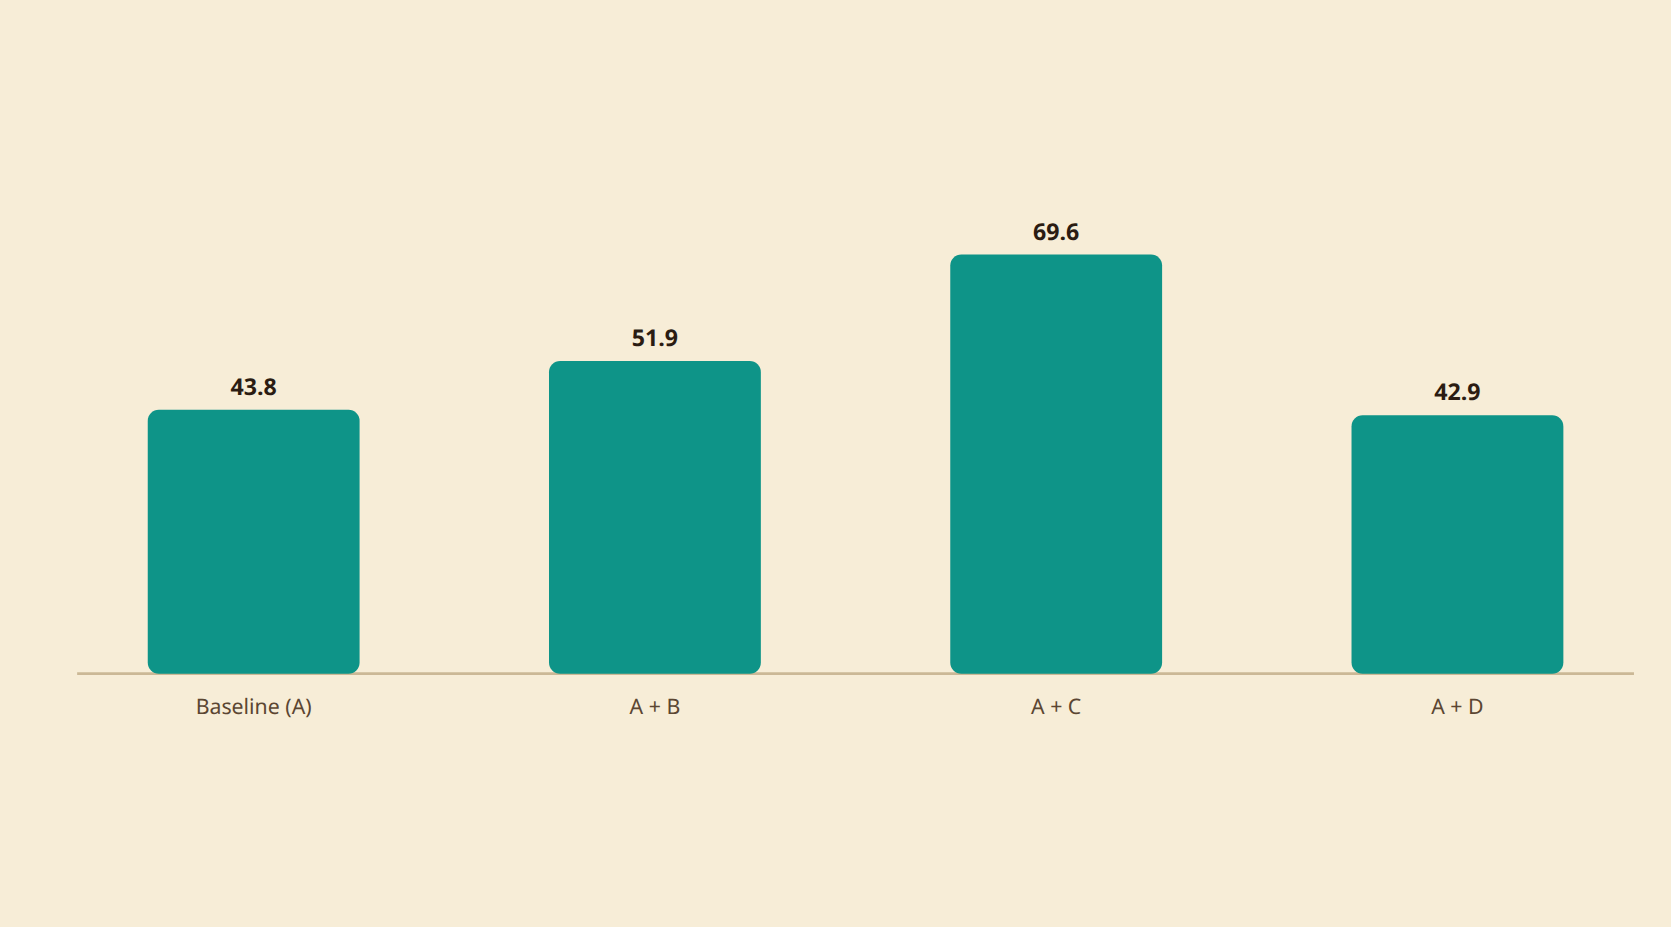
A + C kombinasi terbaik: 69.6% menjadi user, naik jauh dari baseline 43.8%. A+B ada di 51.9%, sementara A+D nyaris tak beda dari baseline (42.9%).
Q4 — Dari Semua Pasangan 2 Platform, Mana yang Paling Optimal?
Saya buat semua kemungkinan pasangan (combn dari 4 platform, ambil 2 — hasilnya 6 pasangan), lalu urutkan berdasarkan proporsi user.
pairs <- combn(c("aware_a","aware_b",
  "aware_c","aware_d"), 2, simplify=FALSE)
pairs |> map(function(p) {
  survey |>
    filter(.data[[p[1]]]=="Ya", .data[[p[2]]]=="Ya") |>
    summarise(pair=paste(p,collapse="+"),
              p_user=round(mean(user_x=="Ya")*100,1))
}) |> list_rbind() |> arrange(desc(p_user))
# A tibble: 6 × 2
  pair  p_user
  <chr>  <dbl>
1 A+C     69.6
2 B+C     68.8
3 C+D     53.3
4 A+B     51.9
5 B+D     45.5
6 A+D     42.9
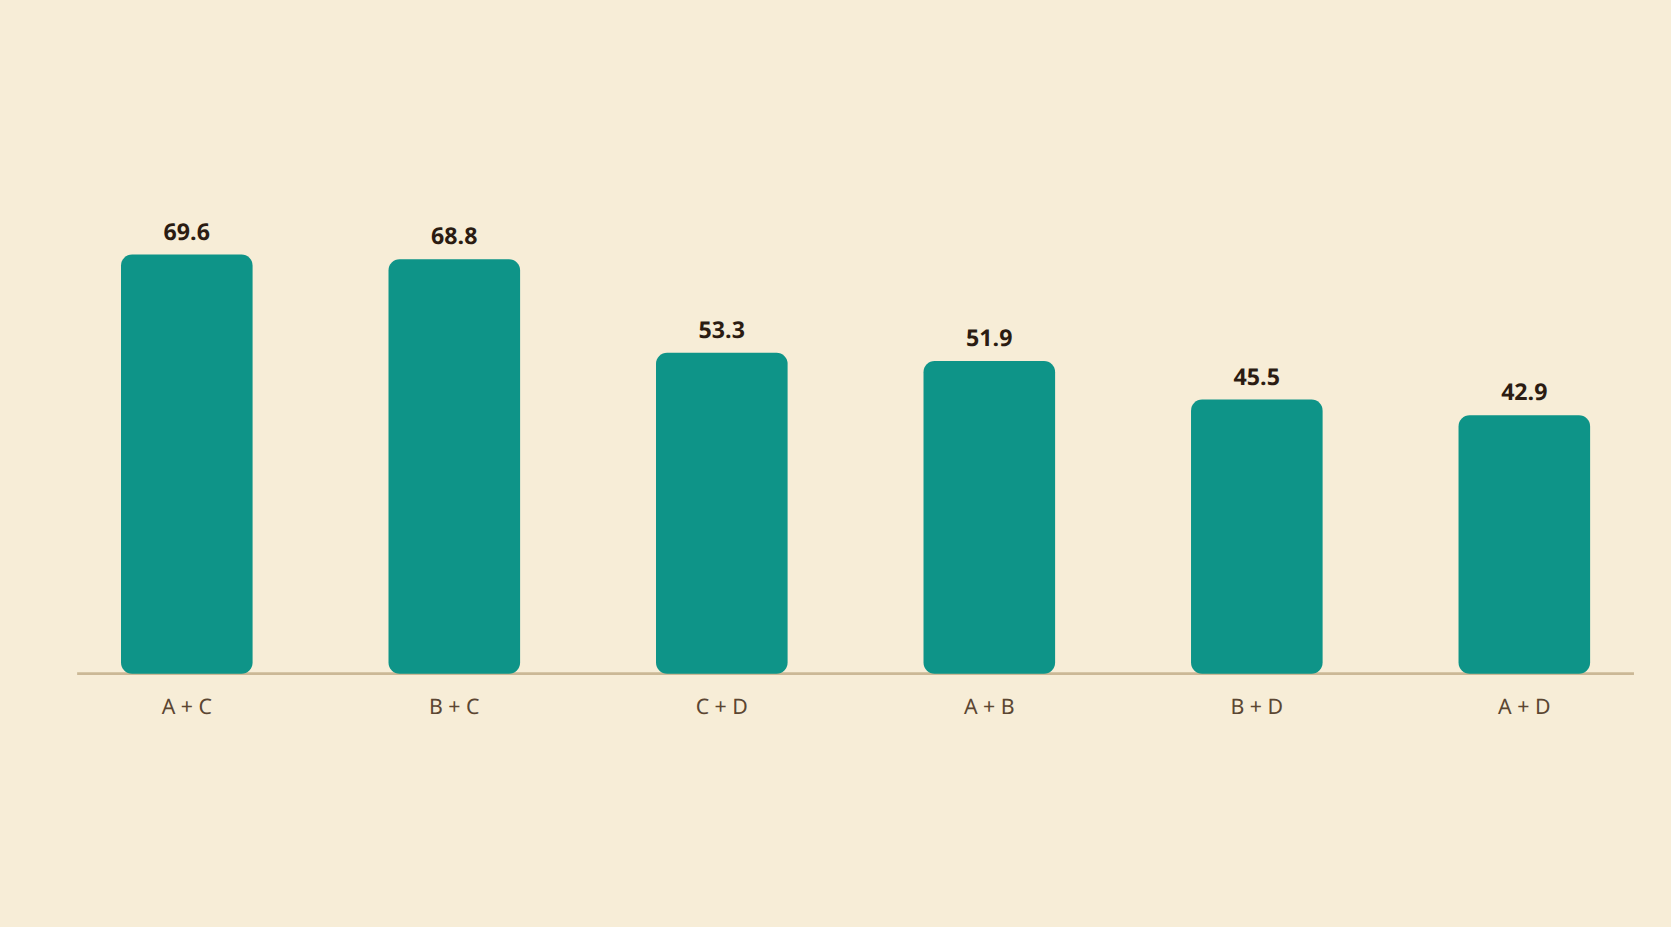
A + C pasangan terbaik: 69.6% menjadi user, disusul B+C di 68.8%. Perhatikan: Platform C tampil di kedua pasangan teratas — sinyal kuat bahwa dia elemen kunci di kombinasi mana pun.
Q5 — Apakah Menambah Platform Terus Worth It?
Pertanyaan ini saya jawab dengan memakai ulang ringkasan dari Q2, lalu hitung selisih (delta) antar level n_aware yang berurutan.
q2_summary <- survey |>
  mutate(n_aware=rowSums(across(
    starts_with("aware_"), ~.x=="Ya"))) |>
  summarise(p_user=round(mean(user_x=="Ya")*100,1),
            .by=n_aware) |> arrange(n_aware)
q2_summary |> mutate(delta=round(p_user-lag(p_user),1))
# A tibble: 5 × 3
  n_aware p_user delta
    <dbl>  <dbl> <dbl>
1       0   22.2  NA
2       1   31.6   9.4
3       2   44.6  13
4       3   55.6  11
5       4  100    44.4
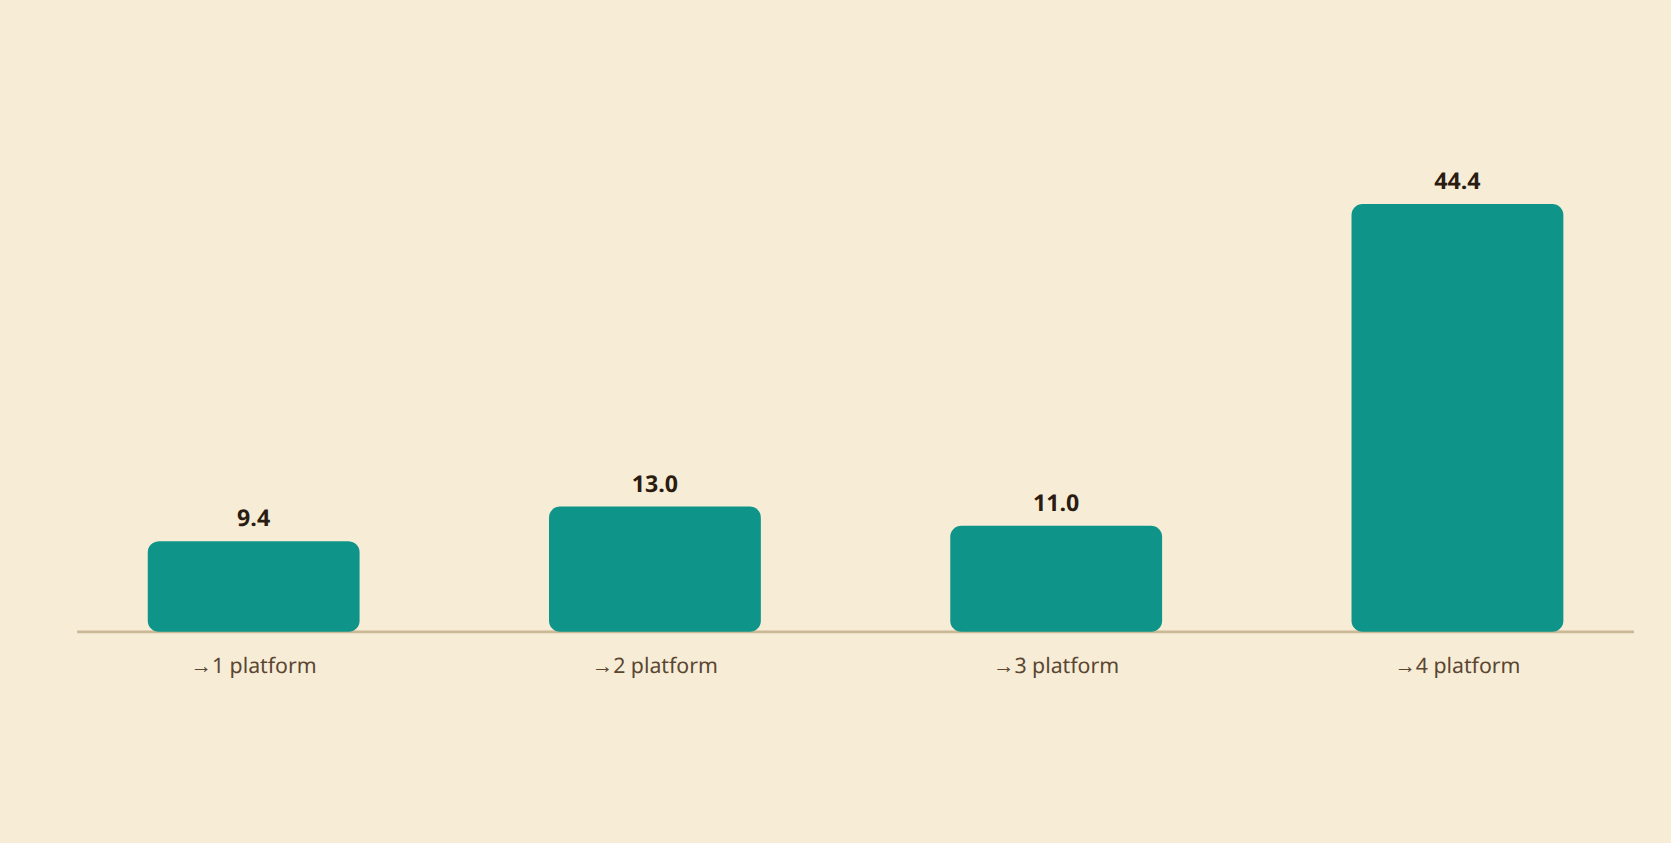
Di sinilah cara manual mulai kelihatan limitasinya: delta-nya “berisik” — naik dari +9.4 ke +13.0, turun ke +11.0, lalu melonjak ke +44.4pp. Lonjakan terakhir itu bukan tanda diminishing returns membalik arah, melainkan artefak sampel kecil (n_aware=4 cuma 2 responden). Manual dengan data mentah rentan kena masalah begini.
Interlude: Bagaimana Naive Bayes Menghitung Skornya?
Sebelum masuk ke babak kedua, ada baiknya kita bedah dulu mesin di balik Naive Bayes lewat satu contoh konkret. Misalkan kita punya profil: aware Platform A & C, tidak aware B & D. Modelnya dilatih begini:
model_nb <- survey |> naiveBayes(user_x ~ ., data = _)

profil <- tibble(aware_a="Ya", aware_b="Tidak",
                 aware_c="Ya", aware_d="Tidak")

predict(model_nb, profil, type = "raw")
Berikut cara menghitung skornya untuk profil di atas, langkah demi langkah:
| Komponen | User = Ya | User = Tidak |
|---|---|---|
| Prior P(Y) | 0.370 | 0.630 |
| Likelihood ∏P(Xᵢ|Y) | 0.0996 | 0.0470 |
| Skor (Prior × Likelihood) | 0.0368 | 0.0296 |
| Posterior (dinormalisasi) | 55.4% | 44.6% |
Cara bacanya dari kiri: mulai dari prior (peluang dasar, 37% dari donut chart tadi), dikalikan likelihood (seberapa “cocok” profil A&C-Ya/B&D-Tidak dengan tiap kelas — masing-masing dihitung terpisah lalu dikalikan, inilah letak asumsi “naif”-nya), hasilnya jadi skor mentah, lalu dinormalisasi (dibagi total kedua skor) supaya jumlahnya 100%. Itulah yang keluar dari predict().
Model mengunci B & D = “Tidak” secara eksplisit, lalu mengalikan semua peluang bersyaratnya sekaligus — satu perhitungan yang menggabungkan seluruh fitur dalam sekali jalan. Mekanisme yang sama persis ini akan dipakai berulang-ulang untuk menjawab Q1 sampai Q5.
Babak 2: Menjawab dengan Model Naive Bayes
Bedanya dengan babak 1: kali ini modelnya dilatih sekali dari 200 data survey, lalu dipakai berulang untuk kelima pertanyaan — tinggal ganti profil input, panggil predict(), baca hasilnya.
- Data Prep — sama seperti sebelumnya
- Latih Model Naive Bayes —
naiveBayes(user_x~., survey), dilatih SEKALI - Susun Profil & predict() — untuk tiap pertanyaan (Q1–Q5), buat skenario input lalu tanya ke model
- Interpretasi Bisnis — terjemahkan posterior model jadi rekomendasi aksi
Q1 via Naive Bayes
Kali ini saya tidak memfilter data asli, melainkan menyusun 4 profil sintetis — masing-masing hanya aware satu platform, tiga lainnya dikunci “Tidak” — lalu meminta model menghitung P(User=Ya) untuk keempatnya sekaligus.
# q1_profiles: 4 skenario, satu platform Ya, tiga lainnya Tidak
pred <- predict(model_nb, q1_profiles |>
    select(-platform), type="raw")
q1_profiles |>
  mutate(p_nb=round(pred[,"Ya"]*100,1)) |>
  select(platform, p_nb)
# A tibble: 4 × 2
  platform  p_nb
  <chr>    <dbl>
1 A         32.8
2 B         27.4
3 C         42.3
4 D         27.2
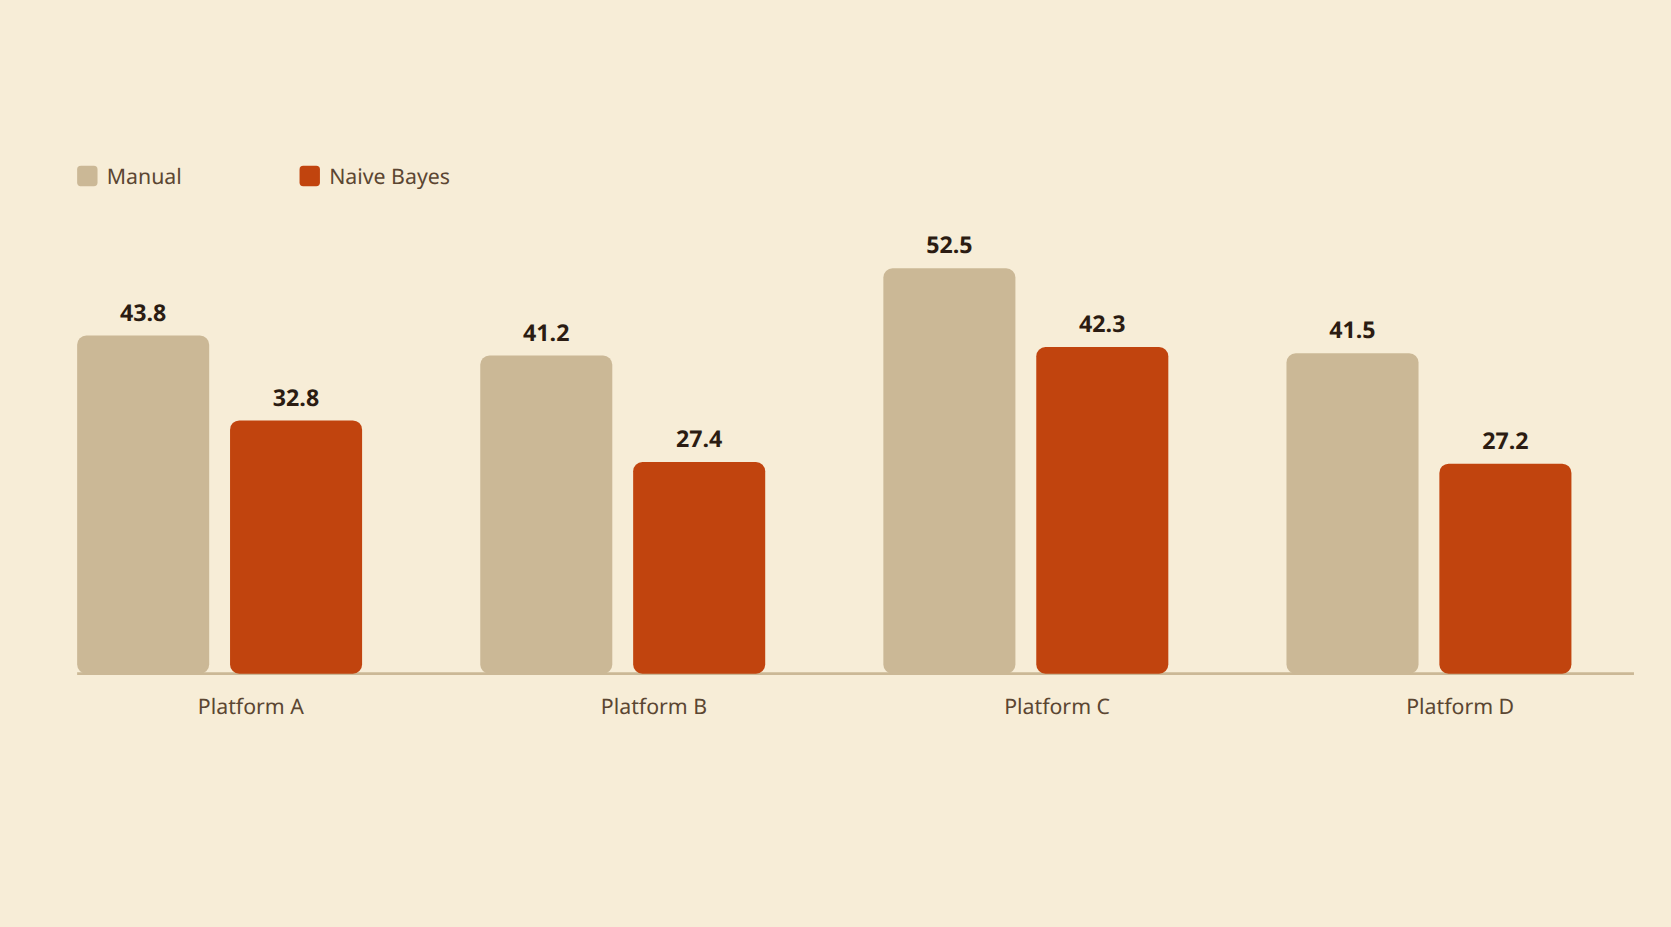
Kedua cara sepakat: Platform C paling berpengaruh (manual 52.5%, Naive Bayes 42.3% — tertinggi di kolom masing-masing). Urutannya identik: C > A > B ≈ D. Bedanya, profil Naive Bayes ini “membekukan” platform lain jadi Tidak, sehingga efek satu platform terlihat lebih terisolasi dibanding data manual yang tercampur exposure platform lain.
Q2 via Naive Bayes
Profilnya kumulatif: k=0 sampai k=4 platform, ditambahkan mulai dari yang paling berpengaruh (C, lalu A, B, D).
# q2_profiles: 5 skenario kumulatif k=0..4
pred_q2 <- predict(model_nb, q2_profiles |>
    select(-k), type="raw")
q2_profiles |>
  mutate(p_nb=round(pred_q2[,"Ya"]*100,1)) |>
  select(k, p_nb)
# A tibble: 5 × 2
      k  p_nb
  <int> <dbl>
1     0  22.4
2     1  42.3
3     2  55.4
4     3  61.9
5     4  67.9
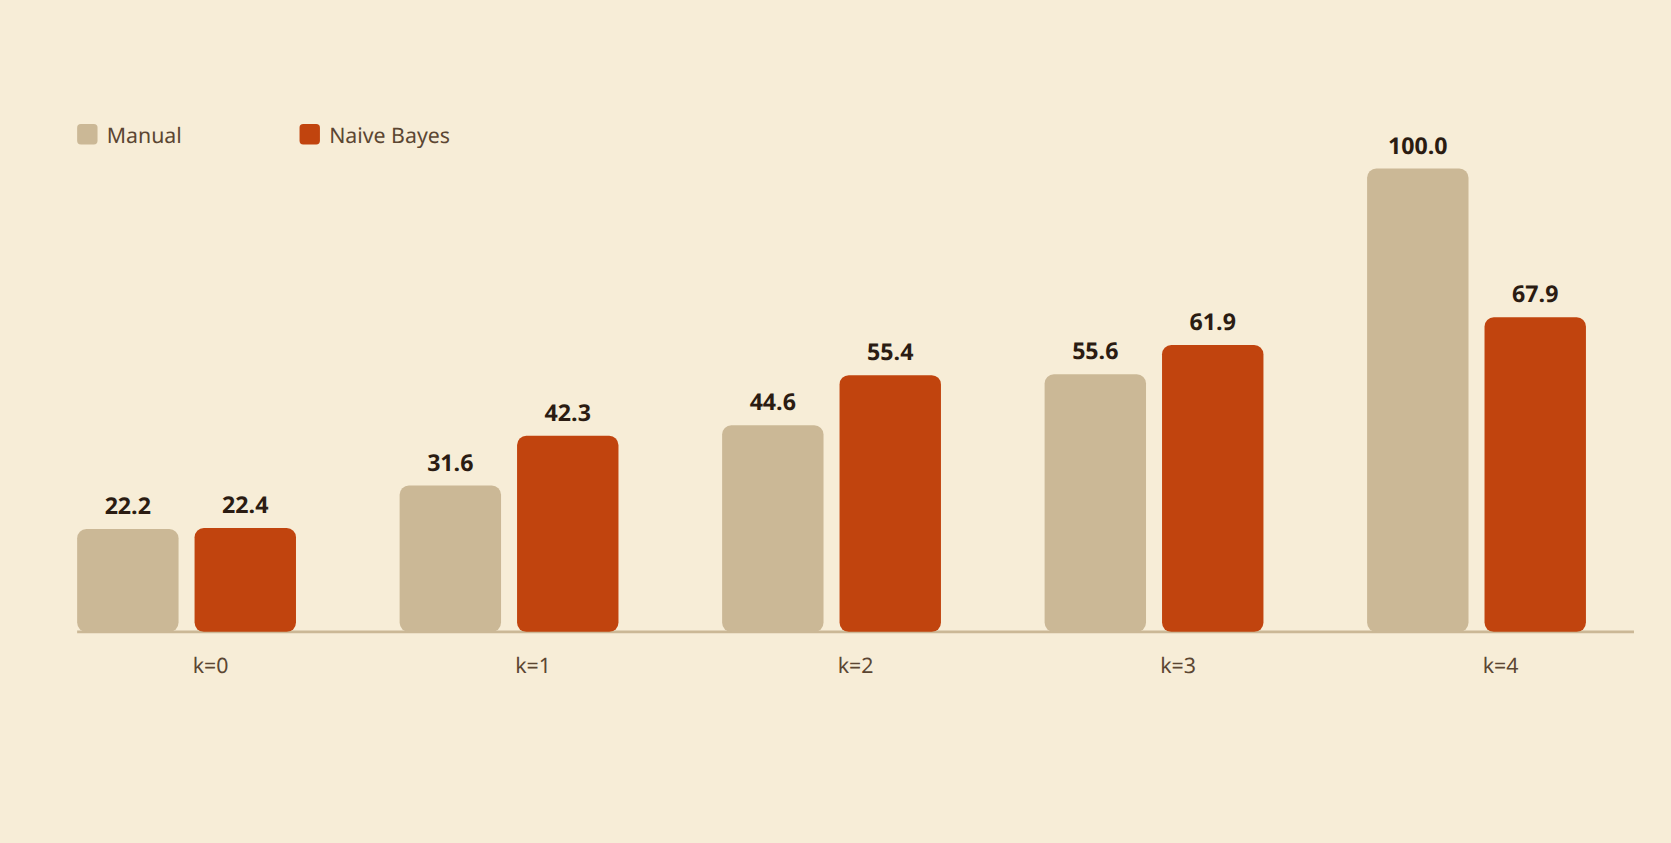
Kedua cara sepakat: makin banyak platform, makin tinggi peluangnya. Manual naik 22.2%→55.6% (k=0-3, k=4 tak andal karena n=2). Naive Bayes naik lebih mulus: 22.4%→67.9% (k=0-4) — tanpa distorsi sampel kecil, karena model menghitung dari seluruh data, bukan cuma segelintir responden yang kebetulan match profil tertentu.
Q3 via Naive Bayes
# q3_profiles: baseline A, lalu A dipasangkan B/C/D
pred_q3 <- predict(model_nb, q3_profiles |>
    select(-kombinasi), type="raw")
q3_profiles |>
  mutate(p_nb=round(pred_q3[,"Ya"]*100,1)) |>
  select(kombinasi, p_nb)
# A tibble: 4 × 2
  kombinasi     p_nb
  <chr>        <dbl>
1 Baseline (A)  32.8
2 A+B           39
3 A+C           55.4
4 A+D           38.8
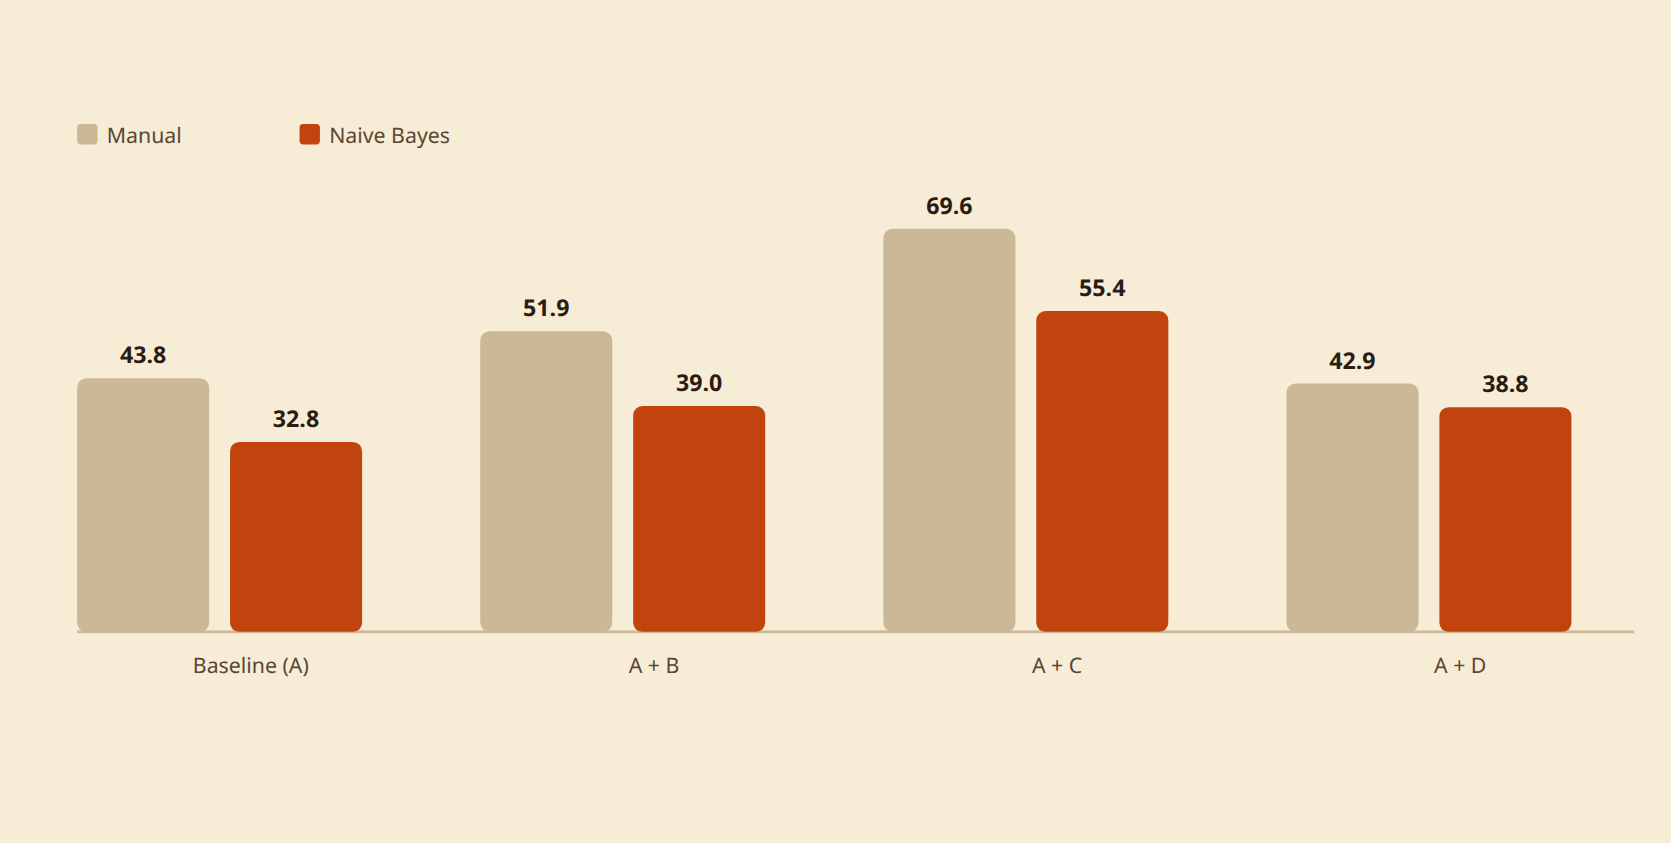
Kedua cara sepakat: A + C kombinasi terbaik. Manual: 69.6% (vs baseline 43.8%). Naive Bayes: 55.4% (vs baseline 32.8%) — levelnya beda, tapi kesimpulannya sama: Platform C memberi lift terbesar ke Platform A.
Q4 via Naive Bayes
# q4_profiles: 6 pasangan, dua platform lain dikunci Tidak
pred <- predict(model_nb, q4_profiles |>
    select(starts_with("aware_")), type="raw")
q4_profiles |>
  mutate(p_nb=round(pred[,"Ya"]*100,1)) |>
  select(pair, p_nb) |> arrange(desc(p_nb))
# A tibble: 6 × 2
  pair   p_nb
  <chr> <dbl>
1 A+C    55.4
2 B+C    49
3 C+D    48.8
4 A+B    39
5 A+D    38.8
6 B+D    32.8
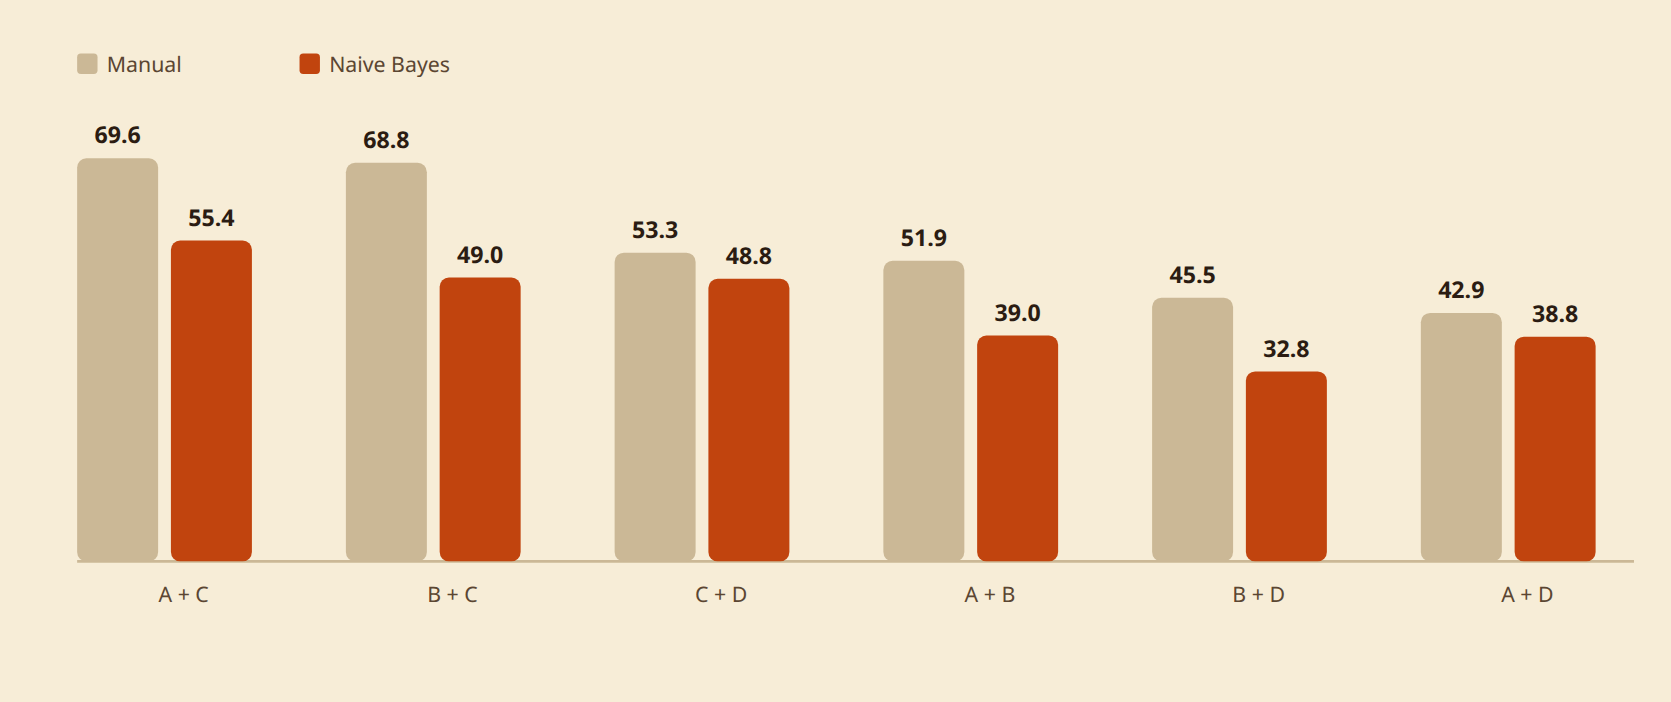
Kedua cara sepakat: A + C pasangan terbaik. Manual: 69.6%, disusul B+C 68.8%. Naive Bayes: 55.4%, disusul B+C 49.0%. Platform C tampil di 3 dari 3 pasangan teratas di kedua metode — makin meyakinkan bahwa dia memang yang paling menentukan.
Q5 via Naive Bayes
# pakai profil kumulatif k=0..4 dari Q2 — model yang sama
q2_profiles |>
  mutate(p_nb=round(pred_q2[,"Ya"]*100,1)) |>
  mutate(delta_nb=round(p_nb-lag(p_nb),1)) |>
  select(k, p_nb, delta_nb)
# A tibble: 5 × 3
      k  p_nb delta_nb
  <int> <dbl>    <dbl>
1     0  22.4  NA
2     1  42.3  19.9
3     2  55.4  13.1
4     3  61.9   6.5
5     4  67.9   6
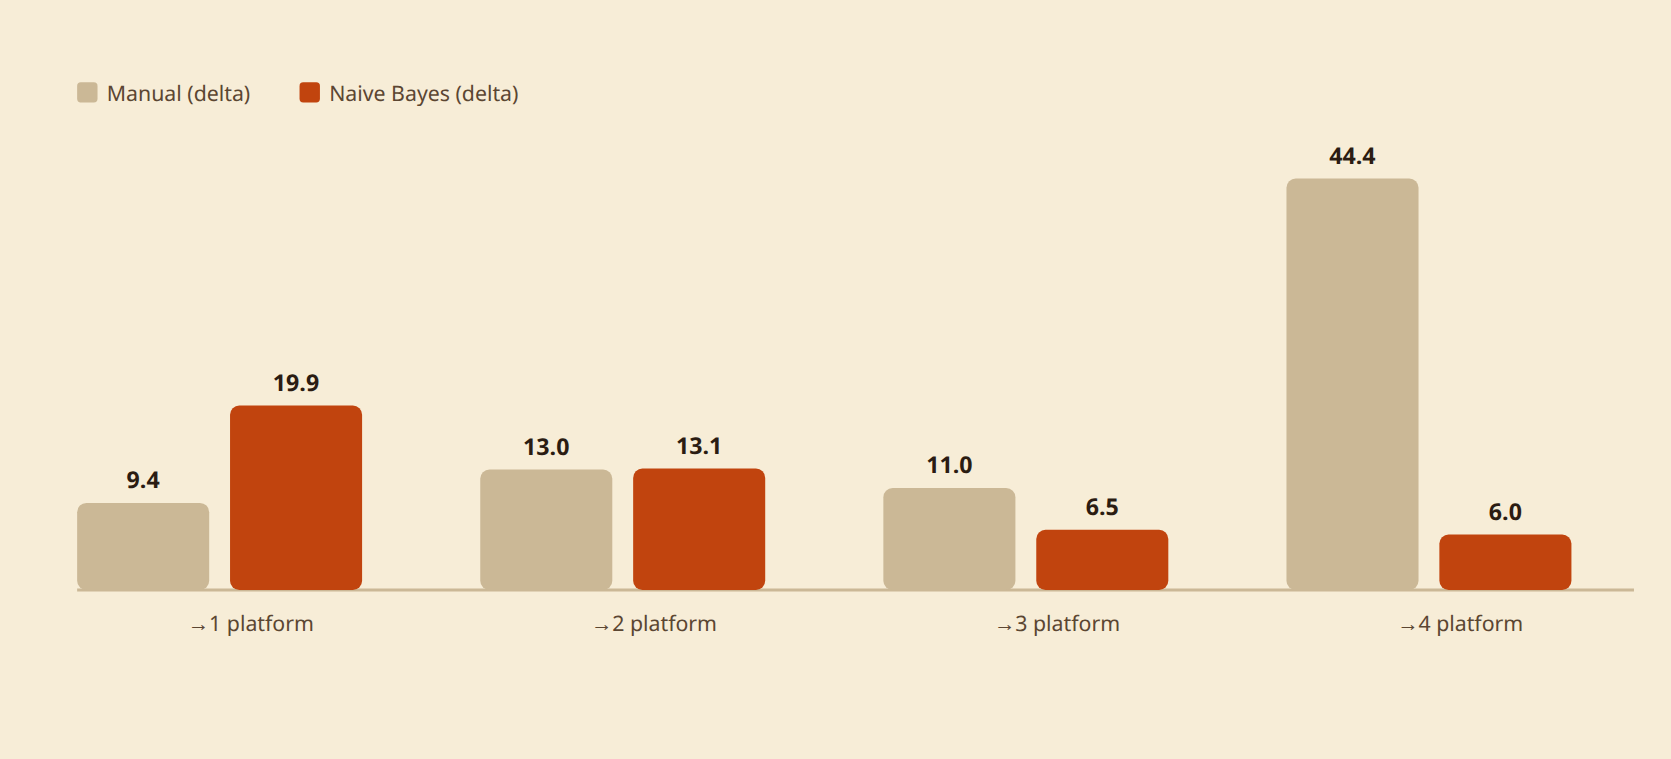
Naive Bayes lebih tegas menunjukkan diminishing returns: delta mengecil mulus +19.9→+13.1→+6.5→+6.0pp. Bandingkan dengan delta manual yang “berisik” (+9.4→+13.0→+11.0→+44.4, melonjak di titik terakhir karena sampel kecil per kelompok). Di sinilah nilai tambah model paling kentara: kesimpulan bisnisnya sama (dua platform terbaik sudah cukup), tapi buktinya jauh lebih meyakinkan dan tidak gampang disalahartikan gara-gara noise data.
Ringkasan: Satu Model Naive Bayes, Lima Jawaban Bisnis
Kalau ditarik benang merahnya, inilah lima jawaban yang kita dapat dan keduanya (manual maupun Naive Bayes) berujung pada kesimpulan bisnis yang sama:
- Faktor penentu: Platform C — posterior P(User=Ya) tertinggi di antara semua platform (42.3%).
- Efek multi-platform: posterior naik monoton 22.4% → 67.9% seiring bertambahnya platform yang aware.
- Kombinasi terbaik dari A: A + C memberi posterior tertinggi (55.4%) dibanding A+B atau A+D.
- Pasangan optimal keseluruhan: A + C tetap juara di antara semua 6 kemungkinan pasangan (55.4%).
- Diminishing returns: kenaikan posterior mengecil tiap tambahan platform (+19.9 → +6.0pp) — dua platform terbaik sudah cukup.
Satu model naiveBayes(user_x~., survey), dilatih sekali, menjawab lima pertanyaan bisnis — tinggal ganti profil input, panggil predict(). Kalau ini kasus nyata, rekomendasinya: prioritaskan budget ke Platform C, pasangkan dengan A, dan tidak perlu memaksakan cakupan keempat platform sekaligus.
Asumsi di Balik Naive Bayes
Sebelum buru-buru pakai Naive Bayes di kasus lain, ada beberapa asumsi yang perlu diingat:
- Independensi fitur — semua prediktor dianggap saling independen, diberi kelasnya. Misalnya, aware Platform A dianggap tidak memengaruhi aware Platform C.
- Distribusi diketahui/diasumsikan — untuk fitur kategorik dipakai distribusi kategorik/multinomial; untuk fitur numerik biasanya diasumsikan mengikuti distribusi normal (Gaussian Naive Bayes).
- Semua fitur relevan — model tidak otomatis menyaring fitur yang tidak berguna; fitur yang tidak informatif tetap ikut memengaruhi hasil.
-
Data cukup representatif — peluang P(Xᵢ Y) dihitung dari data training; kalau sampelnya bias atau kecil, estimasi peluangnya jadi kurang akurat.
Epilog
Yang ingin saya tunjukkan lewat tulisan ini bukan cuma “begini cara pakai Naive Bayes di R”, tapi lebih ke: peluang bersyarat itu bukan materi kuliah yang berhenti di soal ujian. Ia hidup di balik setiap pertanyaan riset pasar yang kita ajukan — dan Naive Bayes cuma cara sistematis untuk menjawabnya lebih cepat, lebih konsisten, dan (seperti yang kita lihat di Q5) kadang lebih jujur ketimbang mengandalkan tabel manual yang gampang goyah oleh sampel kecil.
if you find this article helpful, support this blog by clicking the ads.