Kalau Hujan Turun, Apakah Jualan Warung Ikut Turun? Belajar Regresi Negative Binomial dari Retail Audit
Beberapa hari lalu saya kembali kebagian jatah sharing di LEFO (learning forum internal tim Market Research di kantor). Kali ini saya tidak mau membawa materi yang isinya kelas statistik. Saya membawa satu proyek nyata, yakni retail audit warung, lalu menelusurinya bersama-sama dari pertanyaan bisnis sampai ke keputusan.
Pertanyaan bisnisnya sebenarnya sederhana sekali:
Apakah cuaca benar-benar mengubah penjualan minuman sachet di warung?
Kelihatannya gampang ya. Tinggal bandingkan rata-rata jualan di hari hujan dengan hari cerah, selesai. Tapi di tengah jalan menjawab pertanyaan itu, kami menemukan bahwa cara paling gampang itu justru bisa menyesatkan. Dari situlah kami “ketemu” satu alat yang menurut saya layak dikenal lebih banyak rekan-rekan market researcher: regresi Negative Binomial.
Fokus tulisan ini bukan menurunkan rumus. Fokusnya ada dua:
- Kapan alat ini perlu dipakai, dan
- Bagaimana membaca hasilnya supaya kita tidak salah menyimpulkan.
Oh iya, disclaimer dulu. Di sesi LEFO aslinya ada beberapa analisa yang lebih spesifik. Untuk tulisan ini, saya cukupkan analisanya di level total jualan dan tiga kategori minuman: kopi, teh, dan cokelat.
Data Seperti Ini Ada di Mana-mana
Sebelum masuk ke kasusnya, coba pikirkan: data apa saja yang kita hitung (bukan ukur) dalam pekerjaan sehari-hari?
- Sachet terjual per warung per hari.
- Kunjungan sales per hari.
- Jumlah keluhan konsumen per pekan.
- Jumlah klik iklan per jam.
Semuanya punya tiga ciri yang sama:
- Yang dihitung, bukan diukur. Satuannya pieces: 43 sachet, 7 kunjungan, 2 keluhan. Tidak ada 43,7 sachet, dan angka nol berarti benar-benar tidak ada. Di statistik, data semacam ini disebut data cacah (count data).
- Naik-turunnya itu ciri, bukan noise. Dua warung bisa punya rata-rata harian yang sama persis, tapi sebarannya berbeda jauh. Rata-rata saja tidak akan bisa membedakan keduanya.
- Model menentukan rasa yakin kita. Untuk laporan, rata-rata mungkin sudah cukup. Tapi untuk keputusan, kita perlu tahu seberapa besar bedanya dan seberapa yakin kita boleh mengambil keputusan.
Salah memilih model akan membuat kita jatuh ke salah satu dari dua kesalahan: terlalu yakin pada hal yang belum tentu benar, atau melewatkan efek yang sebenarnya nyata.
Datanya: Retail Audit 20-an Warung Minuman di Jakarta
Konsep risetnya begini: interviewer saya tugaskan untuk mendatangi warung minuman sachet, mencatat jumlah sachet terjual per produk pada hari itu, plus kondisi cuacanya (berapa jam cerah, sangat terik, mendung, dan hujan) saat warung tersebut beroperasional.
| Ringkasan | Nilai |
|---|---|
| Warung | 20-an, semuanya di Jakarta |
| Hari toko dengan data cuaca lengkap | 793 |
| Sachet tercatat | ± 71 ribu |
Rinciannya:
| Periode | Cakupan | Observasi | Sachet |
|---|---|---|---|
| Periode 1 (30 Agu – 22 Okt 2025) | 20-an warung, masing-masing diamati 30 hari | 658 hari toko | 61.530 |
| Periode 2 (17 – 27 Sep 2026) | 20-an warung, ± 9 kunjungan per warung | 135 hari toko | 9.981 |
Semua warung di periode 2 juga ada di periode 1. Artinya, setiap warung bisa dibandingkan dengan dirinya sendiri, bukan dengan warung lain. Dua periode yang berjarak setahun ini juga bukan untuk melihat pertumbuhan, melainkan untuk menguji ketahanan hasil. Kalau kesimpulannya sama, kita bisa lebih tenang.
Isi keranjangnya didominasi kopi sachet (65,5% volume), disusul teh sachet (9,0%), dan sisanya minuman sachet lain, termasuk minuman cokelat.
Ada satu catatan kecil yang nanti jadi penting: cara mencatat durasi cuaca ternyata berbeda antarperiode. Di periode 2, pewawancara sering menulis “24 jam” untuk sehari penuh. Karena itu, cuaca saya ubah menjadi proporsi jam, bukan jumlah jam.
Jualan Hariannya Tidak Pernah Sama
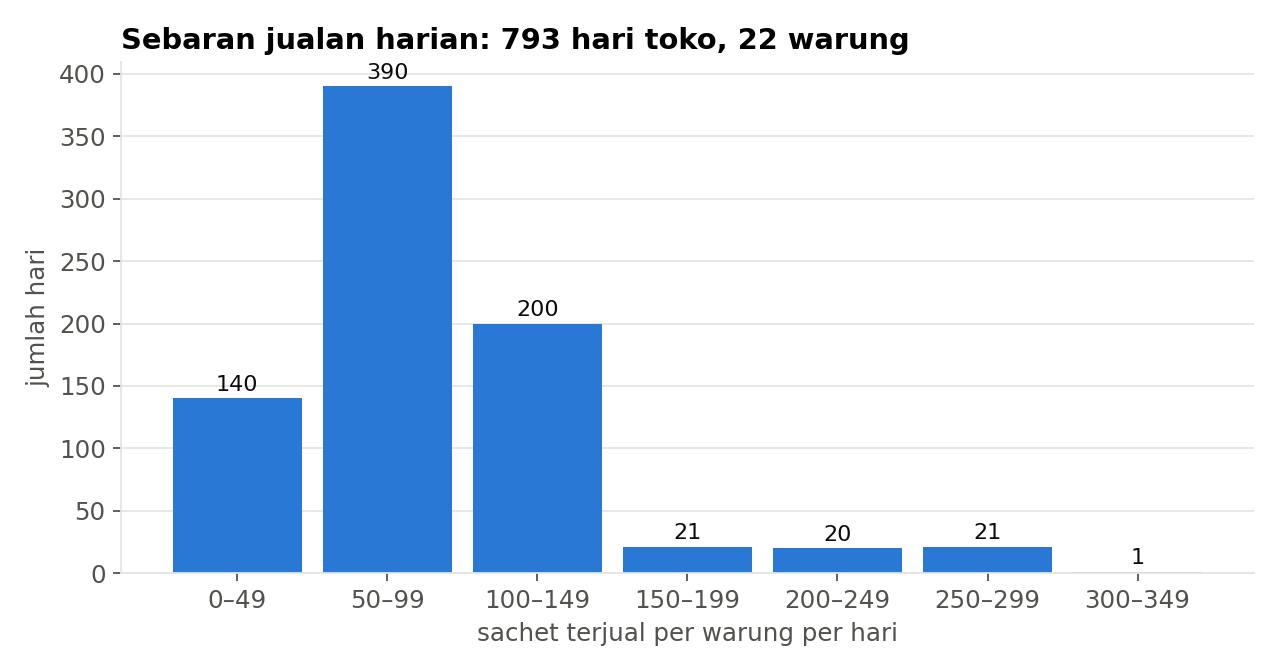
Mari kita lihat dulu sebaran jualan hariannya:
| Statistik | Nilai |
|---|---|
| Rata-rata | 90 sachet per warung per hari |
| Median | 80 sachet |
| Terendah | 18 sachet |
| Tertinggi | 303 sachet |
Rentang dari hari tersepi ke hari teramai hampir 17 kali lipat! Permintaannya menumpuk di kisaran 50–149 sachet (kira-kira tiga per empat hari), lalu ekornya memanjang tipis ke kanan. Bentuknya tidak simetris seperti lonceng.
Sekarang coba bayangkan kalau kita hanya melaporkan “rata-rata jualan warung adalah 90 sachet per hari”. Informasi apa yang hilang?
Jawabannya: seluruh informasi tentang risiko. Seberapa sering hari sepi terjadi dan seberapa ramai hari puncaknya, semuanya tenggelam di balik satu angka rata-rata.
Kenapa Tidak Langsung Pakai Regresi Biasa?
Pertanyaan ini hampir pasti muncul. Apalagi saya sendiri sudah pernah menulis materi training regresi linear di blog ini. Ada tiga alasan kenapa regresi linear kurang pas untuk kasus ini:
| Alasan | Penjelasan |
|---|---|
| Yang kita hitung adalah benda | “Jualan” di sini adalah jumlah sachet. Regresi linear menganggap nilainya bisa berupa angka pecahan di mana saja. |
| Prediksinya tidak boleh negatif | Garis lurus bisa menghasilkan prediksi −20 sachet di hari yang buruk. Di lapangan, itu mustahil. Model untuk data cacah memastikan hasilnya selalu ≥ 0. |
| Efeknya mengalikan, bukan menambah | Hujan tidak mengurangi “10 sachet” di semua warung. Kalau hujan menurunkan jualan 30%, warung yang biasa menjual 100 sachet kehilangan 30, sedangkan warung 200 sachet kehilangan 60. Proporsinya sama, tapi beban absolutnya berbeda. |
Aturan praktisnya:
Data cacah + efek yang mengalikan → mulai dari distribusi Poisson.
Distribusi Poisson: Model Standar untuk Data Cacah
Distribusi Poisson sudah pernah saya bahas di tulisan tentang peristiwa saat training karyawan baru. Singkatnya, model Poisson hanya punya satu parameter, yakni μ (rata-rata jualan):
P(Y = y) = e^(−μ) · μ^y / y!
Asumsi kuncinya cuma satu, tapi sangat ketat:
Var(Y) = μ
Artinya: besar naik-turunnya harus sama dengan rata-ratanya.
Kalau dibuat analogi, Poisson itu seperti orang yang percaya bahwa hari-hari itu mirip-mirip saja. Kalau rata-ratanya 90, maka hari baik dan hari buruk semuanya dekat-dekat dengan 90.
Poisson masuk akal kalau kejadiannya langka dan saling bebas, misalnya jumlah komplain per pekan atau kecelakaan lalu lintas. Kita memulai dari Poisson karena ia adalah titik nol yang jelas: semua model data cacah yang lebih rumit pada dasarnya adalah Poisson yang diberi satu tambahan.
Saat Kita Uji ke Data Kita: Asumsinya Patah!
| Pemeriksaan | Nilai | Yang dijanjikan Poisson |
|---|---|---|
| Rata-rata | 90,0 sachet per hari | – |
| Varians | 2.446,8 | – |
| Varians ÷ rata-rata | 27,2 | 1 |
| Pearson χ² ÷ df (model Poisson) | 8,4 | ≈ 1 |
Cara membacanya begini:
- Dua angka pertama dihitung tanpa mengontrol apa pun. Sebaran mentahnya 27 kali lebih lebar daripada yang diizinkan Poisson.
- Angka 8,4 dihitung setelah perbedaan antarwarung, periode, dan tren waktu diserap ke dalam model. Hasilnya? Poisson tetap 8,4 kali terlalu percaya diri.
Kondisi ini disebut overdispersion: sebaran data lebih lebar daripada yang diizinkan model. Kalau kita tetap memaksakan menggunakan model Poisson, ada dua akibatnya:
- Selang keyakinan jadi terlalu sempit. Kita tampak lebih yakin daripada yang seharusnya.
- p-value jadi terlalu kecil. Efek yang biasa-biasa saja bisa terlihat “signifikan”.
Ini bukan berarti datanya buruk. Justru inilah kenyataan di lapangan. Yang perlu diperbaiki adalah modelnya, bukan datanya.
Naik-Turunnya Punya Dua Sumber
Nah, ini bagian yang menurut saya paling menarik. Ternyata naik-turunnya jualan berasal dari dua sumber yang berbeda:
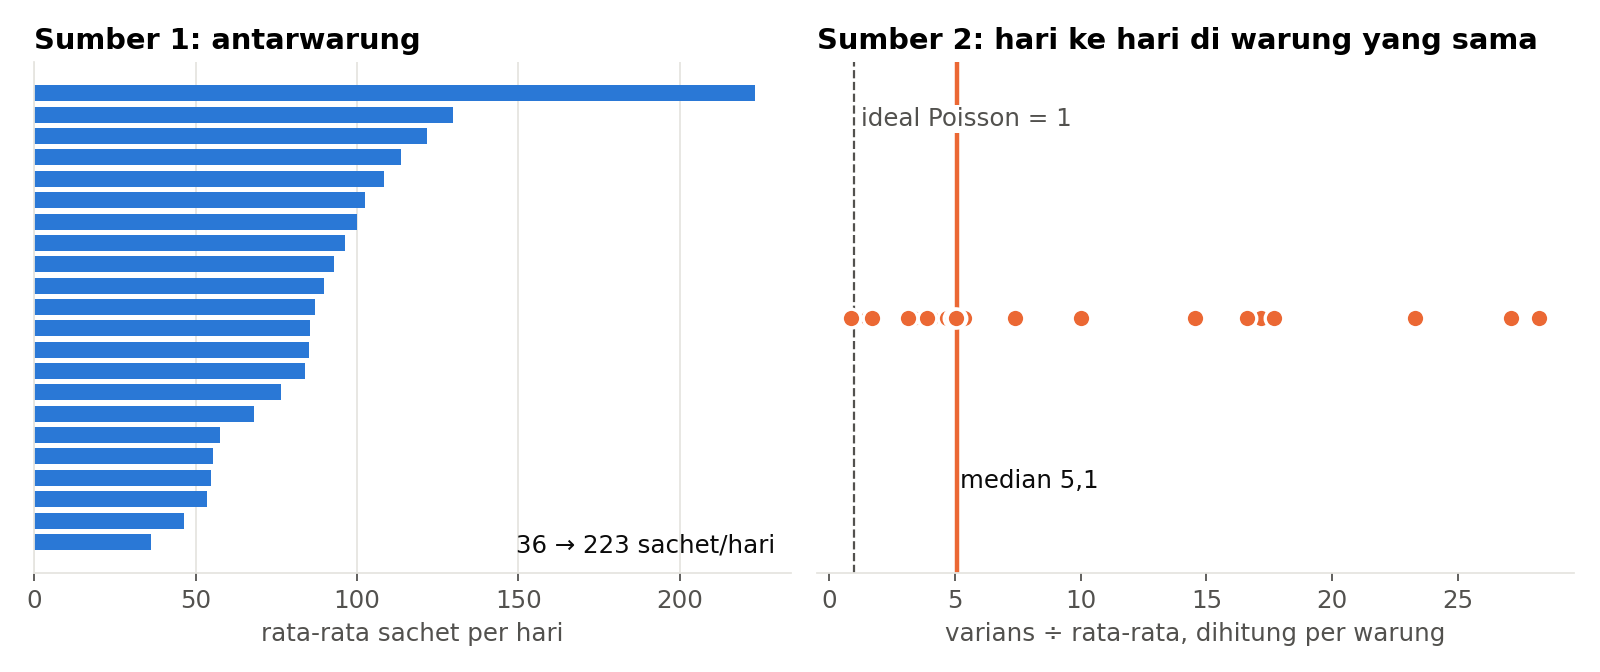
Sumber 1: antarwarung. Rata-rata harian antarwarung bergerak dari 36 sampai 223 sachet, beda hampir 6 kali lipat. Ini soal ukuran dan lokasi warung (misalnya pinggir jalan besar vs di dalam gang), bukan soal cuaca. Solusinya adalah fixed effect warung: setiap warung dibandingkan dengan dirinya sendiri.
Sumber 2: hari ke hari. Di dalam warung yang sama pun, sebarannya masih sekitar 5 kali terlalu lebar (median rasio varians ÷ rata-rata = 5,1, padahal idealnya 1). Ada hari ramai yang tidak terduga, ada juga hari sepi yang tidak terduga. Fixed effect tidak bisa menyentuh sumber yang ini. Inilah sisa yang harus dijawab oleh Negative Binomial.
Pelajarannya: parameter tambahan baru dibutuhkan setelah kedua sumber ini dipisahkan. Kalau tidak dipisahkan, bisa-bisa kita memperbaiki hal yang salah.
Bukti Visual: Poisson vs Kenyataan
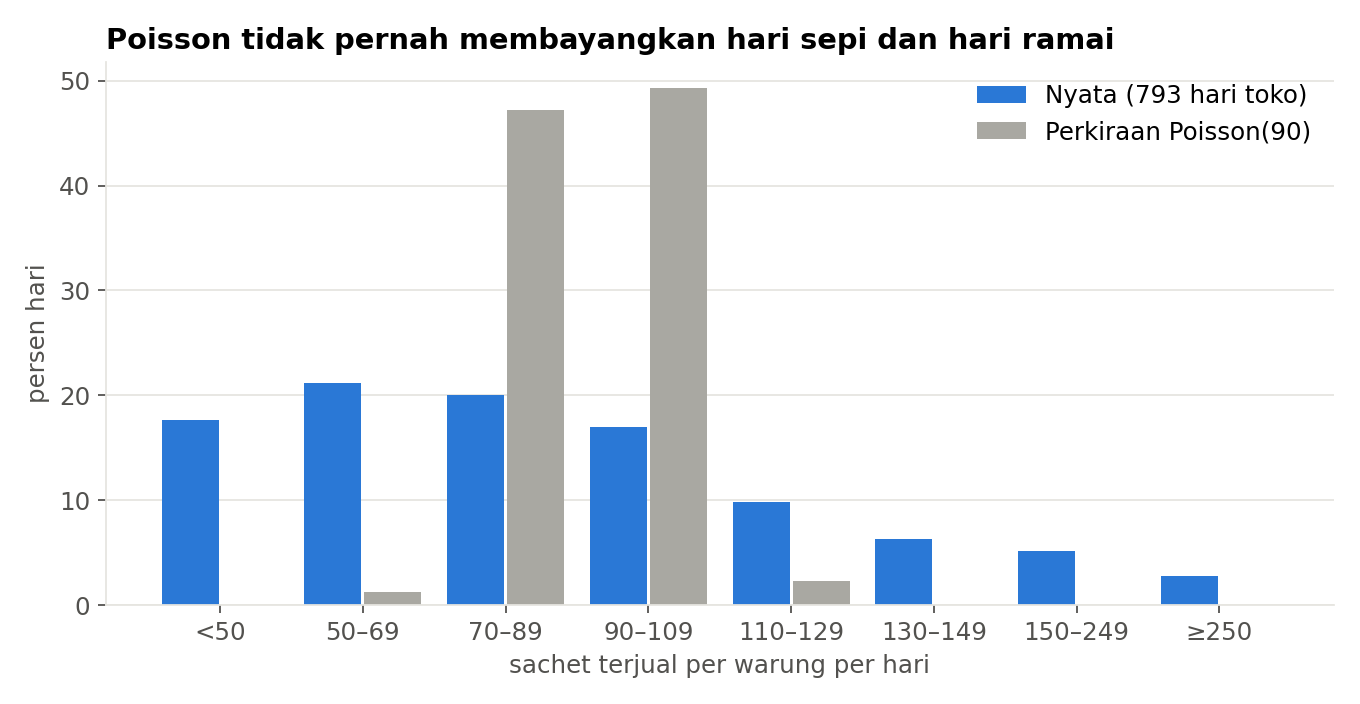
Kalau rekan-rekan hanya mau mengingat satu grafik dari tulisan ini, saya sarankan grafik ini:
| Rentang | Nyata | Perkiraan Poisson(90) |
|---|---|---|
| Hari di bawah 50 sachet | 17,7% | ≈ 0% |
| Hari di rentang 70–109 sachet | 37,1% | 96,5% |
| Hari di atas 150 sachet | 8,0% | ≈ 0% (sekitar satu per sejuta) |
Poisson memperkirakan hampir semua hari jatuh di rentang sempit 70–109 sachet. Kenyataannya, lebih dari separuh hari justru berada di luar rentang itu.
Model yang tidak percaya bahwa hari sepi dan hari ramai itu ada, pasti salah menghitung ketidakpastiannya.
Negative Binomial: Poisson + Satu Parameter
Negative Binomial menambahkan satu “tombol” bernama θ (theta) ke dalam variansnya:
Var(Y) = μ + μ² / θ
μtetap rata-rata jualan.θmengatur selebar apa sebarannya boleh melebar. Jikaθkecil, sebarannya makin lebar. Jikaθbesar, kita kembali lagi ke Poisson.
Secara konsep, Negative Binomial berasal dari campuran Gamma–Poisson. Bahasa manusianya: laju pembeli di setiap hari juga tidak tetap. Kalau harus dijelaskan dalam satu kalimat:
Negative Binomial adalah Poisson yang mengakui bahwa rata-ratanya sendiri bisa berubah-ubah.
Supaya lebih terbayang, berikut ilustrasi untuk rata-rata 90 sachet (varians yang dimodelkan setelah perbedaan antarwarung dikeluarkan):
| Nilai θ | Varians | Dibanding Poisson |
|---|---|---|
| Poisson (tanpa θ) | 90 | 1× |
| θ = 50 | 252 | 2,8× |
| θ = 13,5 (proyek ini) | 690 | 7,7× |
| θ = 5 | 1.710 | 19× |
| θ = 1 | 8.190 | 91× |
Ada dua hal yang perlu diperhatikan:
- Sebagian buku memakai notasi
α = 1/θ, sehingga arah angkanya jadi terbalik. Yang penting konsisten. - Nilai
θitu diestimasi dari data, bukan dipilih oleh analis.
Model yang Saya Pakai
Bentuk modelnya seperti ini:
log(μ) = β0 + β_hujan · prop_hujan + β_mendung · prop_mendung + β_terik · prop_terik
            + β_weekend · weekend + efek warung + periode + tren waktu per periode
Ada empat keputusan penting di balik persamaan ini:
| Keputusan | Alasannya |
|---|---|
| Cuaca sebagai proporsi, bukan jam | Cara mencatat durasi berbeda antarperiode, jadi saya pakai jam kategori ÷ total jam tercatat. Hasilnya tetap bisa dibandingkan antarperiode. |
| Pembandingnya adalah hari cerah | Koefisien dibaca sebagai: hari penuh kategori X dibanding hari penuh cerah. Itu sebabnya hasilnya adalah skenario paling ekstrem. |
| Fixed effect warung | Supaya warung ramai dan warung sepi tidak tercampur ke dalam efek cuaca. |
| Standard error di-_cluster_ per warung | Hari-hari di warung yang sama itu saling mirip. Kalau diabaikan, p-value akan terlihat lebih kecil daripada yang seharusnya. |
Cara Membaca Hasilnya: Satu Angka, Dua Kalimat
Karena efeknya mengalikan, hasil model dilaporkan sebagai pengali. Namanya IRR (incidence rate ratio):
IRR = e^β
Contoh nyatanya adalah efek hujan pada total jualan:
| Koefisien β | IRR = e^β | Perubahan | Selang keyakinan 95% |
|---|---|---|---|
| −0,380 | 0,684 | −31,6% | 0,574 – 0,815 (p < 0,001) |
Kalimat lengkapnya:
“Pada hari yang hujan sepanjang hari, total jualan turun 31,6% dibanding hari yang cerah sepanjang hari.”
Karena selang keyakinannya tidak memuat angka 1, efeknya terbukti secara statistik. Kalau selangnya memuat angka 1, artinya “belum ada bukti yang cukup”, bukan “pasti tidak ada pengaruh”.
Latihan cepat:
- IRR = 0,8 artinya turun 20%.
- IRR = 1,2 artinya naik 20%.
- IRR = 0,5 artinya tinggal separuh.
Satu hal lagi yang paling penting: selalu sebut pembandingnya! Kalimat “hujan menurunkan jualan 32%” tanpa menyebut dibanding apa adalah kalimat yang bisa menyesatkan.
Hasil: Hujan Menekan Penjualan, Akhir Pekan Tidak
Untuk total jualan warung (793 hari toko), hasilnya sebagai berikut:
| Variabel (vs hari penuh cerah) | Perubahan | p-value | Status |
|---|---|---|---|
| Hujan | −31,6% | < 0,001 | Terbukti |
| Sangat terik | +10,9% | 0,11 | Belum terbukti |
| Mendung | +3,0% | 0,55 | Belum terbukti |
| Akhir pekan (vs hari kerja) | −0,5% | 0,83 | Tidak ada bedanya |
Temuan yang cukup mengejutkan bagi saya: akhir pekan sama sekali tidak membedakan jualan warung. Sementara untuk cuaca terik dan mendung, ingat ya: “belum terbukti” itu bukan berarti “tidak berpengaruh”.
Efeknya Tidak Seragam Antarkategori
Hal yang saya suka dari pendekatan ini adalah: satu model bisa menjawab banyak pertanyaan. Kita cukup mengganti kolom yang dihitung (kopi saja, teh saja, atau cokelat saja), lalu menjalankan model yang sama.
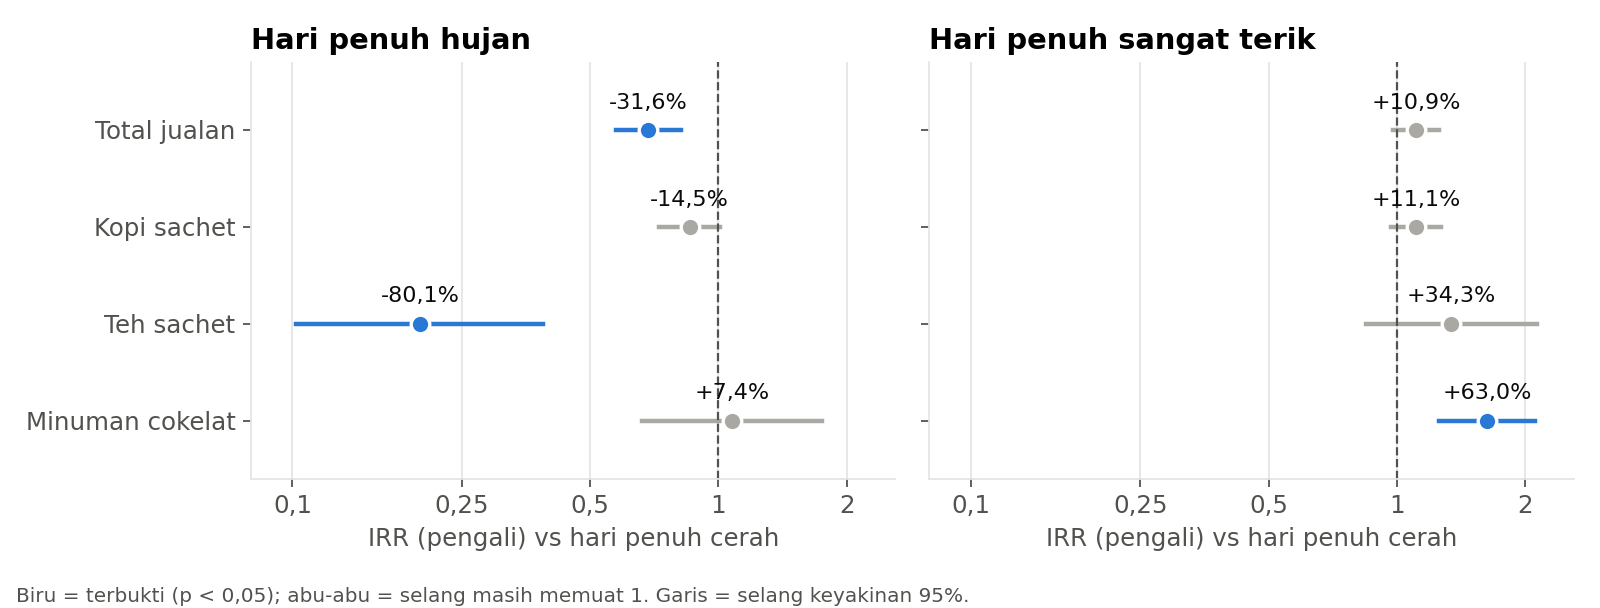
| Kategori | Hujan | Sangat terik | θ |
|---|---|---|---|
| Total jualan | −31,6% (p < 0,001) | +10,9% (p = 0,11) | 13,5 |
| Kopi sachet | −14,5% (p = 0,07) | +11,1% (p = 0,13) | 14,8 |
| Teh sachet | −80,1% (p < 0,001) | +34,3% (p = 0,21) | 3,3 |
| Minuman cokelat | +7,4% (p = 0,77) | +63,0% (p < 0,001) | 5,3 |
Ternyata ada tiga cerita yang berbeda:
- Kopi sachet turun 14,5% saat hujan. Arahnya jelas, tapi buktinya belum cukup (p = 0,07). Kopi relatif lebih tahan banting dibanding kategori lain.
- Teh sachet adalah kategori yang paling rapuh. Pada hari penuh hujan, jualannya tinggal sekitar seperlimanya saja.
- Minuman cokelat tidak terpengaruh hujan, tapi justru naik 63% saat cuaca sangat terik. Apakah ini ada kaitannya dengan cara penyajian (dingin atau hangat)? Menurut saya ini bisa jadi topik diskusi tersendiri.
Kalau kita hanya membaca angka “total”, kita akan melewatkan fakta bahwa teh sachet jauh lebih rapuh dibandingkan kopi.
Kenapa Harus Repot-repot Dimodelkan?
Pertanyaan yang paling sering muncul saat sesi LEFO:
“Kalau cuma mau tahu hujan berpengaruh atau tidak, kenapa tidak bandingkan rata-ratanya saja sih?”
Coba lihat tabel berikut:
| Hari yang ada hujannya vs hari tanpa hujan | Dibandingkan mentah | Setelah dimodelkan |
|---|---|---|
| Total jualan warung | −7,2% | −10,9% |
“Dibandingkan mentah” artinya kita hanya membandingkan rata-rata dua kelompok hari, tanpa kontrol apa pun. Sedangkan model membersihkan tiga hal:
- Komposisi warung. Kalau hari hujan kebetulan lebih banyak jatuh di warung kecil (atau besar), hasilnya jadi bias.
- Cuaca lain. Hari mendung dan hari terik juga ikut menentukan, sehingga harus dihitung bersamaan.
- Periode dan tren. Supaya perubahan antarperiode tidak terbaca sebagai efek cuaca.
Model tidak membuat angkanya jadi lebih cantik. Model membuatnya jadi lebih jujur.
Bukan Cuma Jumlah: Pangsanya Pun Bergeser
Kalau total jualan turun saat hujan, apakah semua kategori ikut turun dengan proporsi yang sama? Ternyata tidak!
Untuk menjawabnya, saya pakai model yang sama, hanya ditambah offset berupa log total jualan. Dengan begitu, yang diprediksi bukan lagi jumlah sachet, melainkan bagian dari total jualan (pangsa alias market share).
| Market share terhadap total jualan | Perubahan | p-value |
|---|---|---|
| Market share kopi sachet, saat hujan | +25,8% | < 0,001 |
| Market share teh sachet, saat hujan | −70,9% | < 0,001 |
| Market share minuman cokelat, saat sangat terik | +42,6% | < 0,001 |
Saat hujan, kopi justru merebut porsi dari kategori lain, sementara porsi teh menyusut drastis. Saat cuaca terik, giliran minuman cokelat yang naik daun.
Bagi kami di market riset, pertanyaan “porsinya bergeser ke mana?” sering kali lebih berguna dibandingkan sekadar “berapa sachet yang terjual?”.
Seberapa Yakin? Ini Buktinya
Model yang lebih rumit hanya bisa dibenarkan kalau kelebihannya bisa diukur. Berikut ukurannya untuk model total jualan:
| Pemeriksaan | Artinya | Poisson | Negative Binomial |
|---|---|---|---|
| Pearson χ² ÷ df | Sisa naik-turun yang belum terserap (idealnya ≈ 1) | 8,36 | 1,10 |
| AIC | Kualitas model dengan “denda” kerumitan (makin kecil makin baik) | 11.052 | 7.333 |
| Uji likelihood-ratio | Apakah perbaikannya nyata? | – | 3.721 (p < 0,0001) |
| θ (galat baku) | Besar tambahan naik-turun yang diestimasi dari data | – | 13,5 (0,79) |
Setelah Negative Binomial dipakai, sisa naik-turunnya sudah wajar (1,10). AIC turun lebih dari 3.700 poin, dan uji likelihood-ratio memastikan bahwa θ memang dibutuhkan.
Kesimpulannya Bertahan Walau Modelnya Diutak-atik
Saya juga mencoba beberapa variasi model untuk menguji apakah kesimpulannya rapuh atau tidak:
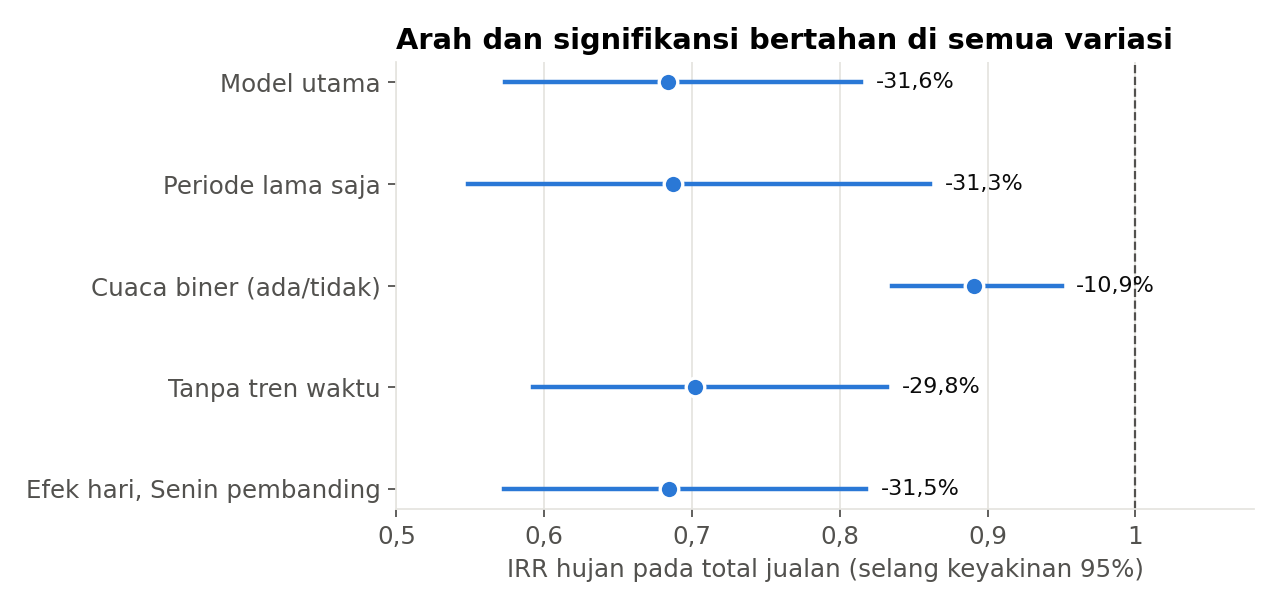
| Variasi model | Efek hujan pada total jualan |
|---|---|
| Model utama | −31,6% |
| Periode lama saja | −31,3% |
| Cuaca biner (ada hujan / tidak) | −10,9% |
| Tanpa tren waktu | −29,8% |
| Efek per hari (Senin sebagai pembanding) | −31,5% |
Semua variasi memberikan arah yang sama dan tetap signifikan. Variasi “cuaca biner” memang hasilnya lebih kecil, dan itu wajar karena yang dihitung bukan lagi hujan sepanjang hari, melainkan sekadar “ada hujan atau tidak”.
Kalau sebuah kesimpulan berubah hanya karena cara menulis modelnya diganti, itu tandanya kesimpulan tersebut rapuh.
Epilog
Limitasi
Sebelum menutup, saya rasa penting untuk jujur soal limitasi dari analisa ini:
- Hari hujan penuh hampir tidak pernah terjadi. Dari 793 hari, hanya 2 hari yang hujan sepanjang hari. Jadi angka −31,6% (total) dan −80,1% (teh) adalah ekstrapolasi model ke skenario paling ekstrem. Angka ini berguna untuk melihat arah, bukan untuk dijanjikan sebagai angka pasti.
- Kejadian yang rutin justru dampaknya lebih ringan. Hujan terjadi di 28,5% hari, dengan durasi rata-rata sekitar 4 jam saja. Untuk versi yang paling sering kita hadapi ini, total jualan turun 10,9% dan teh sachet turun 31,4%. Inilah angka yang paling dekat dengan kenyataan sehari-hari.
- Yang ditemukan adalah hubungan, bukan sebab-akibat. Modelnya menunjukkan hubungan yang konsisten dan tahan diuji. Tapi untuk klaim sebab-akibat, kita butuh desain riset lain, misalnya eksperimen.
- Cakupannya terbatas. Hanya 22 warung di satu kota selama dua periode. Belum tentu berlaku untuk wilayah atau musim lain.
Menuliskan limitasi bukan tanda analisanya lemah. Justru inilah yang membuat kesimpulannya layak dipakai untuk mengambil keputusan.
Ada satu hal lagi yang menarik: angka yang paling dramatis justru yang paling jarang bisa diamati langsung di lapangan. Sementara angka yang paling sering terjadi malah “sepi perhatian”, padahal angka itulah yang menentukan operasional sehari-hari.
Kapan Negative Binomial Belum Cukup, dan Kapan Malah Berlebihan?
Negative Binomial belum cukup kalau…
| Kondisi | Alternatif |
|---|---|
| Banyak angka nol karena warung tutup (nol karena tutup itu berbeda sifatnya dengan nol karena sepi) | ZINB atau model hurdle |
| Datanya berjenjang (hari di dalam warung, warung di dalam kota) | Random effect atau model berjenjang |
| Naik-turunnya tumbuh linear, bukan kuadratik | NB1 atau quasi-Poisson |
Negative Binomial justru berlebihan kalau… overdispersion-nya memang tidak ada. Kalau varians ÷ rata-rata sudah sekitar 1, Poisson lebih baik karena lebih sederhana dan selang keyakinannya lebih sempit.
Contoh nyatanya ada di proyek ini juga. Model pangsa kopi punya nilai θ ≈ 2,3 × 10¹⁰, alias praktis tak berhingga. Di situ Negative Binomial dan Poisson menghasilkan kesimpulan yang sama, jadi Poisson saja sudah cukup. Sebaliknya, teh sachet (θ = 3,3) dan minuman cokelat (θ = 5,3) sebarannya sangat lebar, sehingga Negative Binomial wajib dipakai.
Urutannya selalu seperti ini:
Poisson → cek dispersi → Negative Binomial → baru model yang lebih rumit. Jangan dibalik!
Lima Jebakan yang Paling Sering Terjadi
- Memulai dari rata-rata. Rata-rata dua warung bisa sama persis, padahal sebarannya berbeda jauh. Mulailah dari sebaran.
- p-value di atas 0,05 langsung dianggap “tidak ada pengaruh”. Kopi sachet turun 14,5% dengan p = 0,07. Arahnya konsisten dan bisa dijelaskan, yang belum cukup hanyalah keyakinannya.
- Standard error tanpa cluster. Hari-hari di warung yang sama itu saling mirip. Kalau ini diabaikan, kita jadi tampak lebih yakin daripada yang sebenarnya.
- Angka ekstrapolasi dibaca sebagai fakta. “Hujan sepanjang hari” hanya teramati 2 hari dari 793 hari. Sampaikan sebagai arah, sambil menyebut angka yang benar-benar terjadi.
- Hubungan dibaca sebagai sebab. Model yang bagus pun tidak otomatis membuktikan sebab-akibat. Untuk itu kita butuh desain riset, bukan sekadar model yang lebih rumit.
Buat rekan-rekan market researcher atau data scientist yang sering berurusan dengan data penjualan harian, semoga tulisan ini bisa jadi titik awal yang berguna.
if you find this article helpful, support this blog by clicking the ads.