Memaksa Bulan Puasa Masuk ke Model Forecast Sales: Belajar dari Regresi dan Kolom Lebaran
Selama ini saya terbiasa melakukan forecast dengan metode time series. Baik di pekerjaan kantor dan juga saat menuliskan beberapa artikel di blog ini. Namun ada satu kelemahan saat saya menggunakan time series. Apa itu?
Saya selalu gagal dalam “memaksa” pengaruh bulan puasa ke dalam model time series saya tersebut.
Bagi rekan-rekan yang bekerja di industri FMCG, pasti paham betul rasanya. Bulan puasa dan Lebaran adalah momen paling besar dalam setahun. Penjualan naik tajam menjelang Lebaran, lalu anjlok saat toko dan gudang tutup di hari-hari libur. Masalahnya, momen ini tidak pernah jatuh di bulan yang sama. Setiap tahun, Lebaran maju sekitar 11 hari.
Beberapa waktu lalu rekan saya (Mas Dito) menyusun materi ajar Financial Analytics. Salah satu kasusnya adalah membuat forecast penjualan bulanan untuk keperluan budgeting. Saat melihat materinya, sepertinya saya menemukan jawaban dari masalah saya. Sekarang saya tahu bagaimana caranya memasukkan efek Lebaran ke dalam model forecast.
Jawabannya ternyata tidak rumit. Bahkan bisa dibilang cukup sederhana. Kuncinya: berhenti memikirkan Lebaran sebagai “bulan”, dan mulai memikirkannya sebagai “jumlah hari”.
Tulisan ini adalah rangkuman dari materi tersebut, plus sedikit “pengakuan dosa” atas cara saya membuat forecast di artikel-artikel sebelumnya.
Kilas Balik: Bagaimana Saya Membuat Forecast Selama Ini?
Sebelum masuk ke kasusnya, saya mau jujur dulu. Saya iseng membuka kembali artikel-artikel lama di blog ini yang berkaitan dengan forecast. Ternyata polanya cukup jelas:
| Artikel | Metode | Bagaimana musiman dan hari raya ditangani? |
|---|---|---|
| Membuat Forecast Sales yang Menghemat 8 Miliar Rupiah! (2023) | Dekomposisi time series, forecast = rata-rata trend 6 bulan terakhir | Komponen musiman praktis dibuang, hanya trend yang dipakai. Tidak ada penanganan hari raya. |
| Time Series Forecasting dengan TensorFlow (2023) | LSTM, jendela 6 bulan → 1 bulan | Tidak ada fitur musiman atau hari raya. |
| Forecasting Menggunakan Prophet (2025) | Prophet dengan setting default | Hanya musiman bawaan Prophet, tanpa kalender hari libur. |
| Membuat MMM dengan META Robyn part II (2025) | Robyn + dekomposisi Prophet | Memakai kalender libur Prophet untuk Indonesia, tapi Idul Fitri hanya ditandai sebagai satu-dua hari libur, bukan periode belanja menjelang Lebaran. |
| Forecast Harga Emas dengan Bayesian Time Series (2025) | BSTS | Tidak relevan (data harga emas harian). |
| Nowcasting: Menebak Angka Sales Bulan Ini (2026) | Regresi dengan factor(bulan) + hariraya |
Ada variabel “bulan hari raya”, tapi koefisiennya keluar NA karena bertabrakan dengan variabel bulan (singularities). |
| Mengukur Sensitivitas Konsumen terhadap Harga (2026) | Regresi dengan is_ramadan |
Ramadan di-_hardcode_ sebagai bulan 3 dan 4, padahal posisinya bergeser setiap tahun. |
Melihat tabel di atas, saya jadi senyum-senyum sendiri. Ada tiga “dosa” yang terus berulang:
- Musiman dianggap tetap. Model time series klasik (dekomposisi, Holt-Winters, ARIMA musiman, Prophet default) mengasumsikan pola musiman berulang di bulan yang sama setiap tahun. Maret ya Maret.
- Hari raya dianggap sebagai “bulan”. Saat mencoba memasukkan Lebaran, saya membuat dummy bulan: 1 kalau bulan Lebaran, 0 kalau bukan. Akibatnya informasinya bertabrakan dengan variabel bulan itu sendiri.
- Lebaran dianggap satu titik. Padahal dampaknya terjadi berminggu-minggu sebelumnya (orang belanja selama bulan puasa), lalu berbalik arah saat libur.
Di tulisan ini, ketiga hal itu akan kita perbaiki satu per satu.
Kasusnya: Budget Penjualan 2027
Bayangkan sebuah distributor makanan kemasan. Setiap bulan Oktober, mereka menyusun budget penjualan untuk tahun depan. Budget-nya harus per bulan, bukan cuma satu angka tahunan, karena stok, tenaga kerja, dan arus kas disiapkan per bulan.
Disclaimer: perusahaannya fiktif. Tapi tanggal Lebarannya asli.
Cara yang selama ini dipakai perusahaan tersebut sangat sederhana:
Forecast Maret 2026 = Aktual Maret 2025 × (1 + pertumbuhan tahun lalu)
Sederhana bukan? Ingat-ingat rumus ini, karena sebentar lagi kita akan mengujinya.
Datanya adalah penjualan bulanan dari Januari 2019 sampai September 2026, total 93 bulan, dalam satuan miliar rupiah.
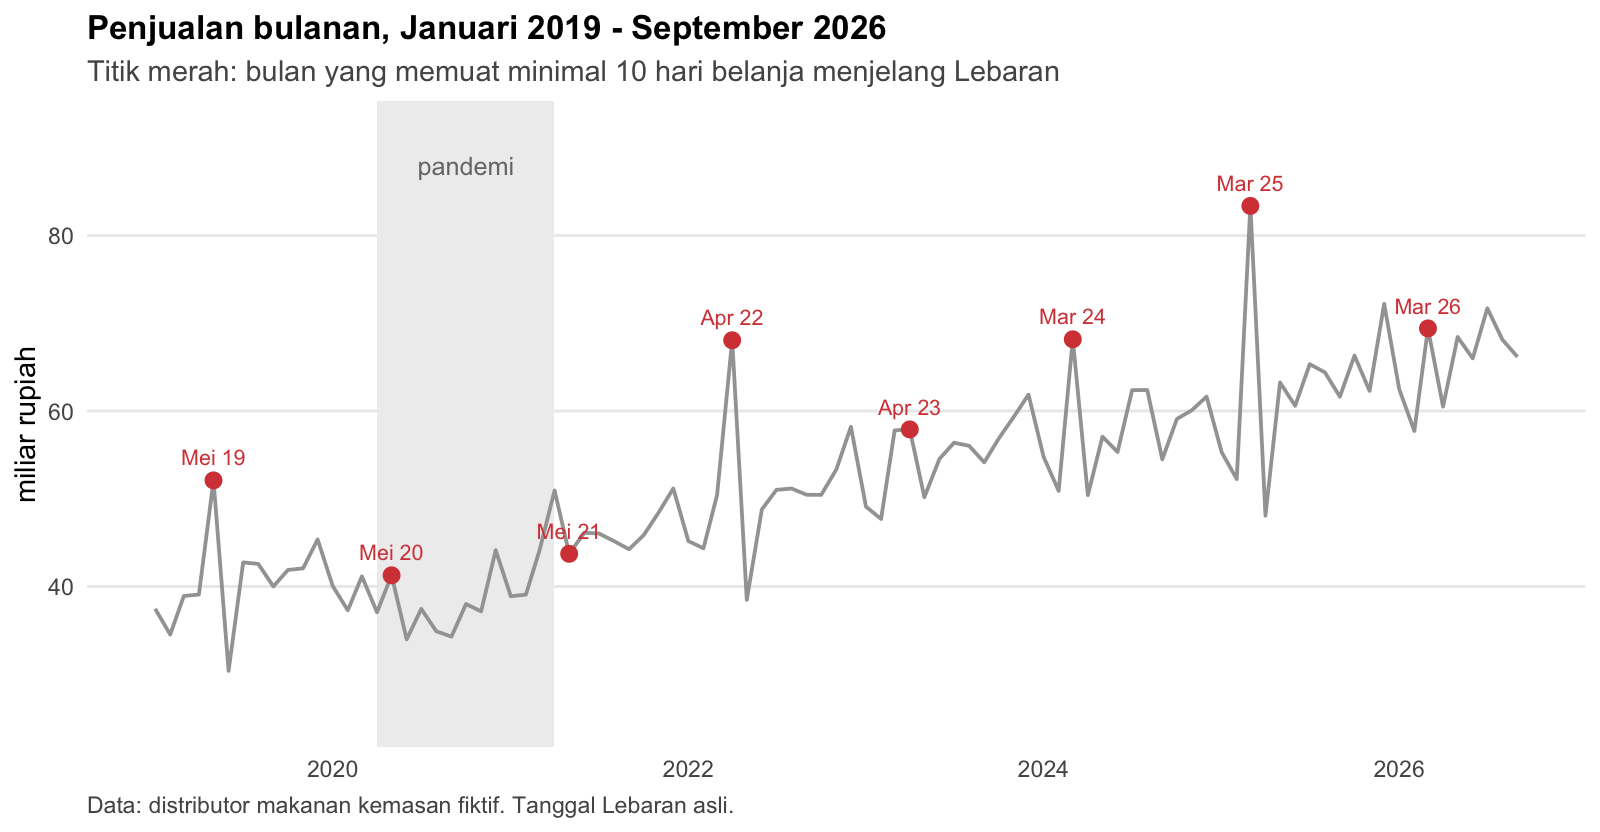
Dari grafik di atas, ada tiga hal yang langsung terlihat:
- Penjualan tumbuh, dari sekitar 38 miliar menjadi sekitar 70 miliar per bulan.
- Ada periode pandemi (April 2020 sampai Maret 2021) di mana penjualan tertekan.
- Beberapa puncak tertinggi jatuh di bulan Lebaran. Perhatikan posisinya: Mei di 2019, April di 2022, Maret di 2024 dan 2025. Puncaknya berpindah-pindah, dan itu yang membuat model berbasis kalender kebingungan. Tapi tidak semua puncak berasal dari Lebaran: di 2020, 2021, 2023, dan 2026 puncaknya justru Desember atau Juli, yang memang pola akhir tahun dan libur sekolah.
Kenapa Time Series Selalu Gagal Menangkap Lebaran?
Mari kita bedah datanya dengan cara yang paling sering saya pakai: dekomposisi. Penjualan dipecah menjadi tiga bagian:
Penjualan = Trend + Musiman + Sisa
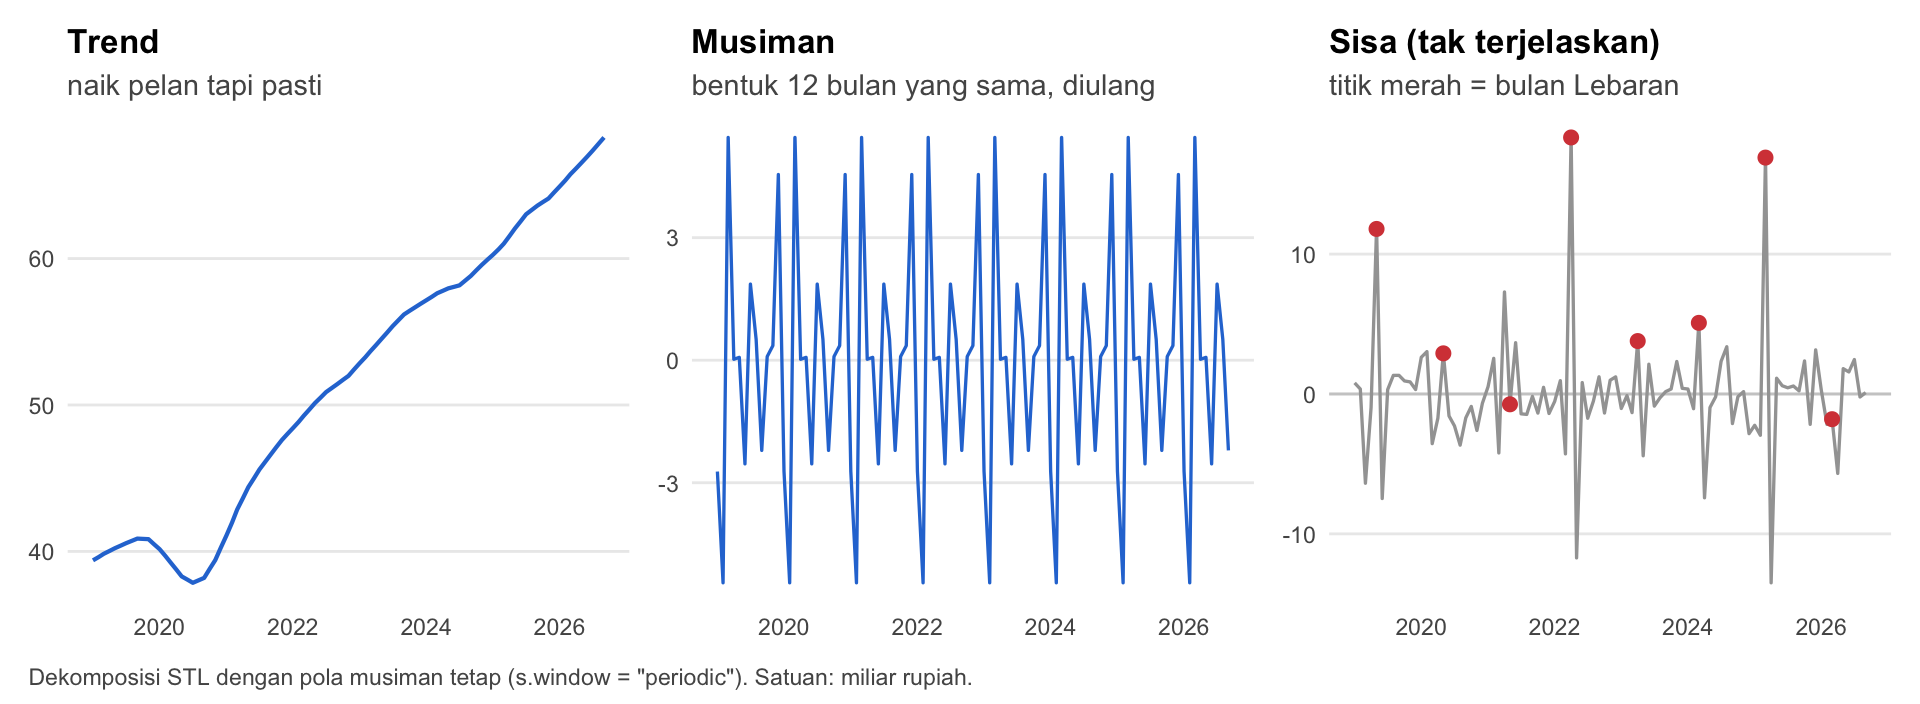
- Trend naik dengan rapi. Tidak ada masalah.
- Musiman adalah bentuk 12 bulan yang sama, diulang setiap tahun. Desember selalu tinggi, Februari selalu rendah.
- Sisa adalah apa yang tidak bisa dijelaskan oleh trend dan musiman. Lihat titik-titik merahnya. Sisa terbesar justru muncul di bulan-bulan Lebaran.
Sebagai contoh, April 2022 (Lebaran jatuh 2 Mei 2022):
| Komponen | Nilai (miliar Rp) |
|---|---|
| Aktual | 68,06 |
| Trend | 49,70 |
| Musiman April | +0,02 |
| Sisa | +18,34 |
Bayangkan, 18 miliar “tidak terjelaskan” dalam satu bulan!
Kenapa ini terjadi? Karena dekomposisi (dan hampir semua model time series musiman) bekerja dengan logika kalender Masehi. Sementara Lebaran mengikuti kalender Hijriah, yang setiap tahunnya lebih pendek sekitar 11 hari.
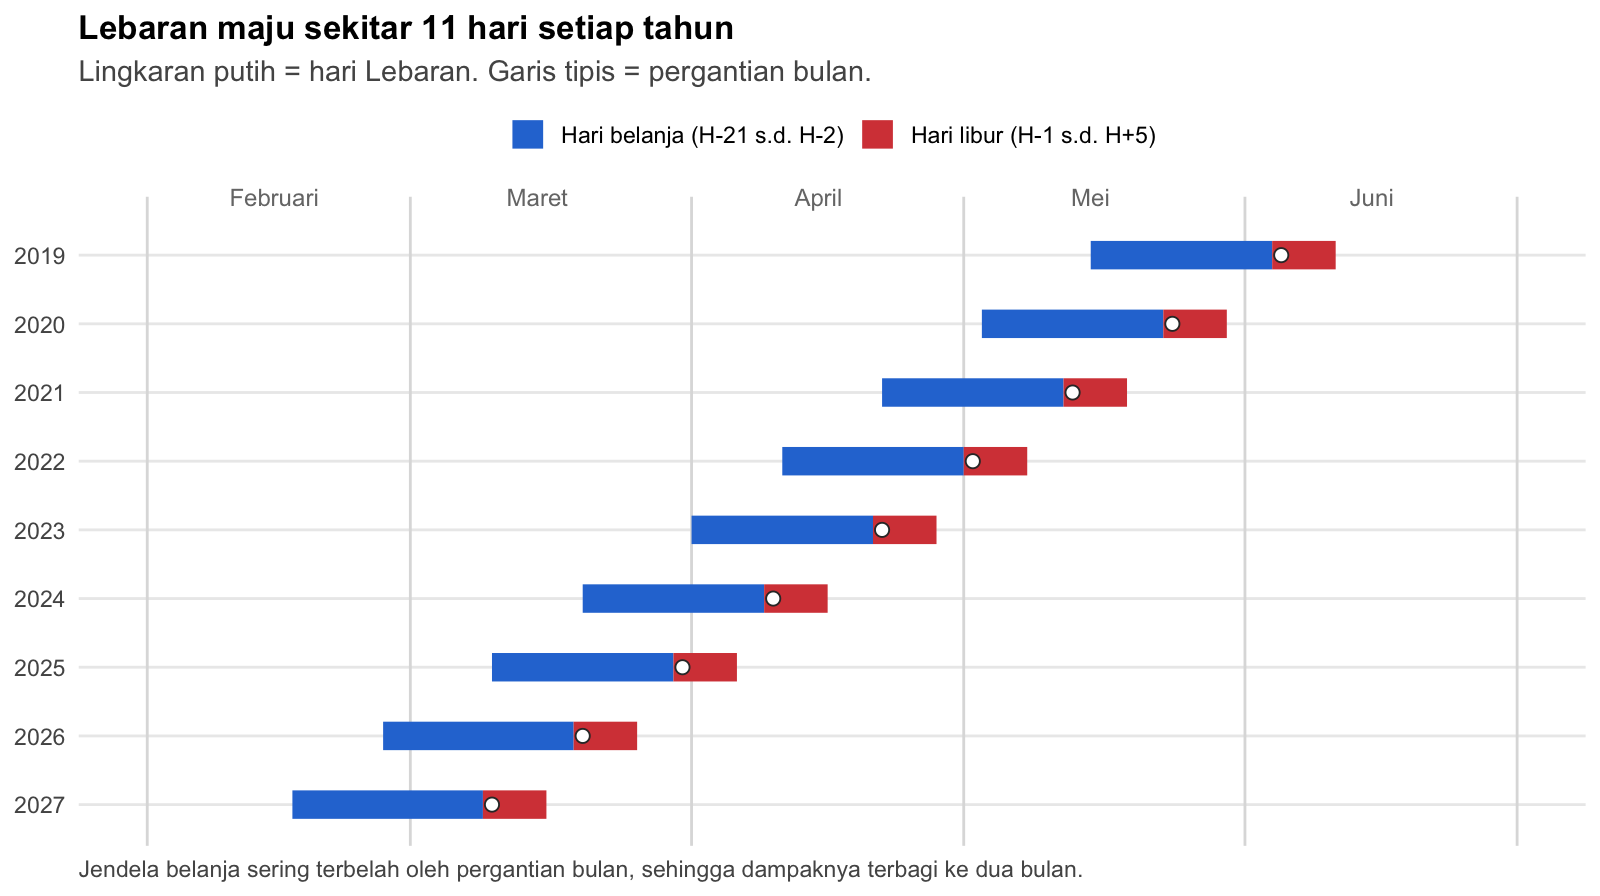
Grafik di atas menunjukkan dua hal penting:
- Lebaran terus maju. Dari 5 Juni (2019) ke 20 Maret (2026), lalu sekitar 10 Maret (2027).
- Jendela belanja sering terbelah oleh pergantian bulan. Lihat tahun 2026: sebagian hari belanja jatuh di akhir Februari, sebagian besar di Maret. Di 2027, hari belanjanya justru sebagian besar jatuh di Februari.
Jadi wajar kalau komponen “musiman Maret” kebingungan. Kadang Maret berisi Lebaran, kadang tidak. Kadang hanya setengahnya.
Saya Coba Pakai Time Series Murni
Supaya adil, saya coba jalankan dua model time series yang paling sering dipakai: ETS (Holt-Winters) dan Auto ARIMA dari library(forecast). Keduanya dilatih dengan data Januari 2019 sampai September 2025, lalu diminta memprediksi 12 bulan berikutnya (Oktober 2025 sampai September 2026).
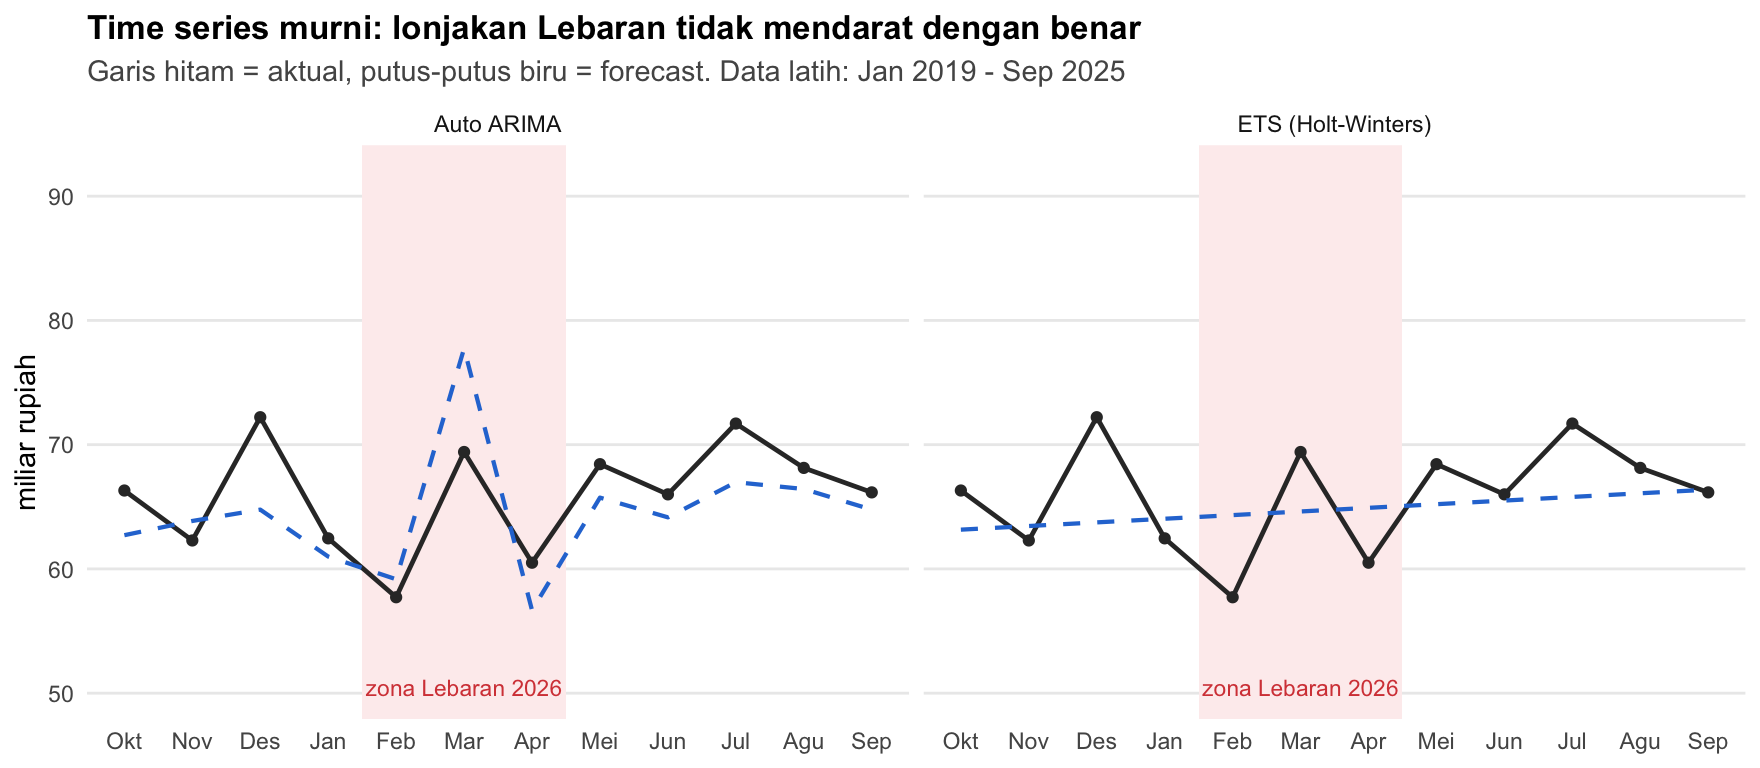
Hasilnya menarik:
- ETS memilih model tanpa musiman sama sekali, yaitu
ETS(M,A,N). Polanya terlalu “berantakan” bagi ETS, sehingga ia menyerah dan hanya menarik garis lurus. - Auto ARIMA memilih
ARIMA(0,1,2)(1,0,0)[12]. Komponen musimannya menyalin lonjakan Maret 2025 (saat itu Lebaran jatuh 31 Maret) ke Maret 2026. Hasilnya Maret 2026 diprediksi 77,7 miliar, padahal aktualnya 69,4 miliar.
Inilah persis kegagalan yang selama ini saya alami. Model time series belajar bahwa “Maret itu tinggi”, padahal yang sebenarnya tinggi adalah “hari-hari menjelang Lebaran”.
Cara Lama: Tahun Lalu + Pertumbuhan
Sekarang kita uji rumus perusahaan tadi. Supaya adil, kita pakai posisi yang sama dengan saat menyusun budget: berdiri di akhir September 2025, lalu memprediksi 12 bulan ke depan sekaligus.
Langkah pertama, hitung pertumbuhan 12 bulan terakhir yang sudah diketahui:
g = (total sales Okt 2024 - Sep 2025) / (total sales Okt 2023 - Sep 2024) - 1
  = 735,00 / 693,97 - 1
  = 5,91%
Langkah kedua, kalikan setiap bulan tahun lalu dengan (1 + g). Contoh: Maret 2026 = 83,37 × 1,0591 = 88,30.
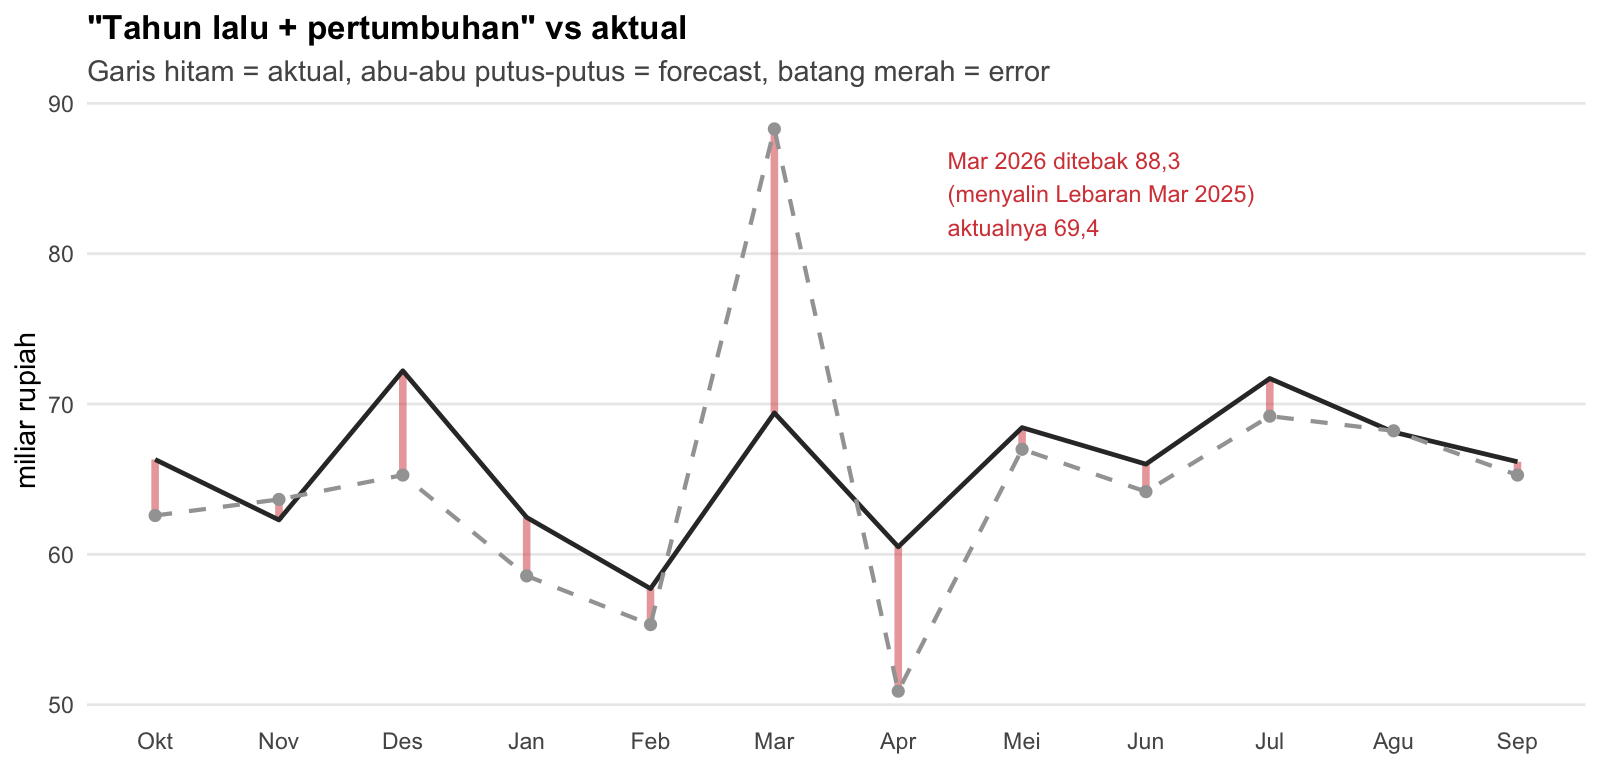
Lihat batang merah di Maret dan April. Karena Maret 2025 memuat Lebaran, rumus ini menyalin lonjakannya ke Maret 2026. Padahal Lebaran 2026 jatuh lebih awal. Di April, terjadi kesalahan sebaliknya.
Bagaimana Mengukur “Seberapa Meleset”?
Ukuran yang akan kita pakai di sepanjang tulisan ini adalah MAPE (mean absolute percentage error), yakni rata-rata persentase kesalahan:
MAPE = rata-rata dari ( |forecast - aktual| / aktual ) x 100%
| Bulan | Perhitungan | Error |
|---|---|---|
| Okt 2025 | |62,58 − 66,31| ÷ 66,31 | 5,6% |
| Mar 2026 | |88,30 − 69,41| ÷ 69,41 | 27,2% |
| Apr 2026 | |50,90 − 60,50| ÷ 60,50 | 15,9% |
| … 9 bulan lainnya | ||
| Rata-rata 12 bulan | 80,7 ÷ 12 | 6,7% |
Dua bulan Lebaran (Maret dan April) menyumbang lebih dari separuh total kesalahan: 43,1 dari 80,7 poin. Jadi kalau kita bisa membereskan Lebaran, setengah masalah selesai.
Cara Baru: Regresi yang Dibangun dalam Tiga Langkah
Alih-alih memakai model time series, kita akan memakai regresi linear biasa. Ya, regresi yang sama dengan yang kita pelajari di kelas statistik dasar. Bedanya, kita akan “merakit” kolom-kolomnya dengan sengaja, satu langkah demi satu langkah.
| Langkah | Kolom yang ditambahkan | Yang ingin ditangkap |
|---|---|---|
| 1 | Indeks waktu (1, 2, 3, …) + dummy pandemi | Pertumbuhan |
| 2 | 11 kolom bulan (Februari s.d. Desember) | Musiman tahunan |
| 3 | Jumlah hari belanja dan jumlah hari libur Lebaran | Efek Lebaran |
Persamaan lengkapnya:
ln(sales) = b0 + b1*waktu + b2*pandemi                 # langkah 1
               + bFeb*Feb + ... + bDes*Des             # langkah 2
               + bBelanja*hari_belanja + bLibur*hari_libur   # langkah 3
Ada dua pertanyaan yang biasanya muncul di kelas:
Kenapa pakai ln (logaritma natural)? Supaya setiap koefisien bisa dibaca sebagai persentase perubahan, dengan rumus efek = exp(b) - 1. Pertumbuhan dan pola musiman dalam bisnis biasanya bersifat proporsional (naik sekian persen), bukan tambahan dengan nilai tetap (naik sekian miliar).
Kenapa tidak ada kolom Januari? Karena Januari menjadi titik acuan. Coba perhatikan: kalau semua kolom Februari sampai Desember bernilai 0, bulan itu pasti Januari. Kolom Januari tidak akan memberi informasi baru. Setiap koefisien bulan kemudian dibaca sebagai “seberapa tinggi atau rendah dibandingkan Januari?”. Pemilihan Januari hanya karena ia bulan pertama. Bulan apa pun bisa dijadikan acuan, dan hasil forecast-nya akan sama persis.
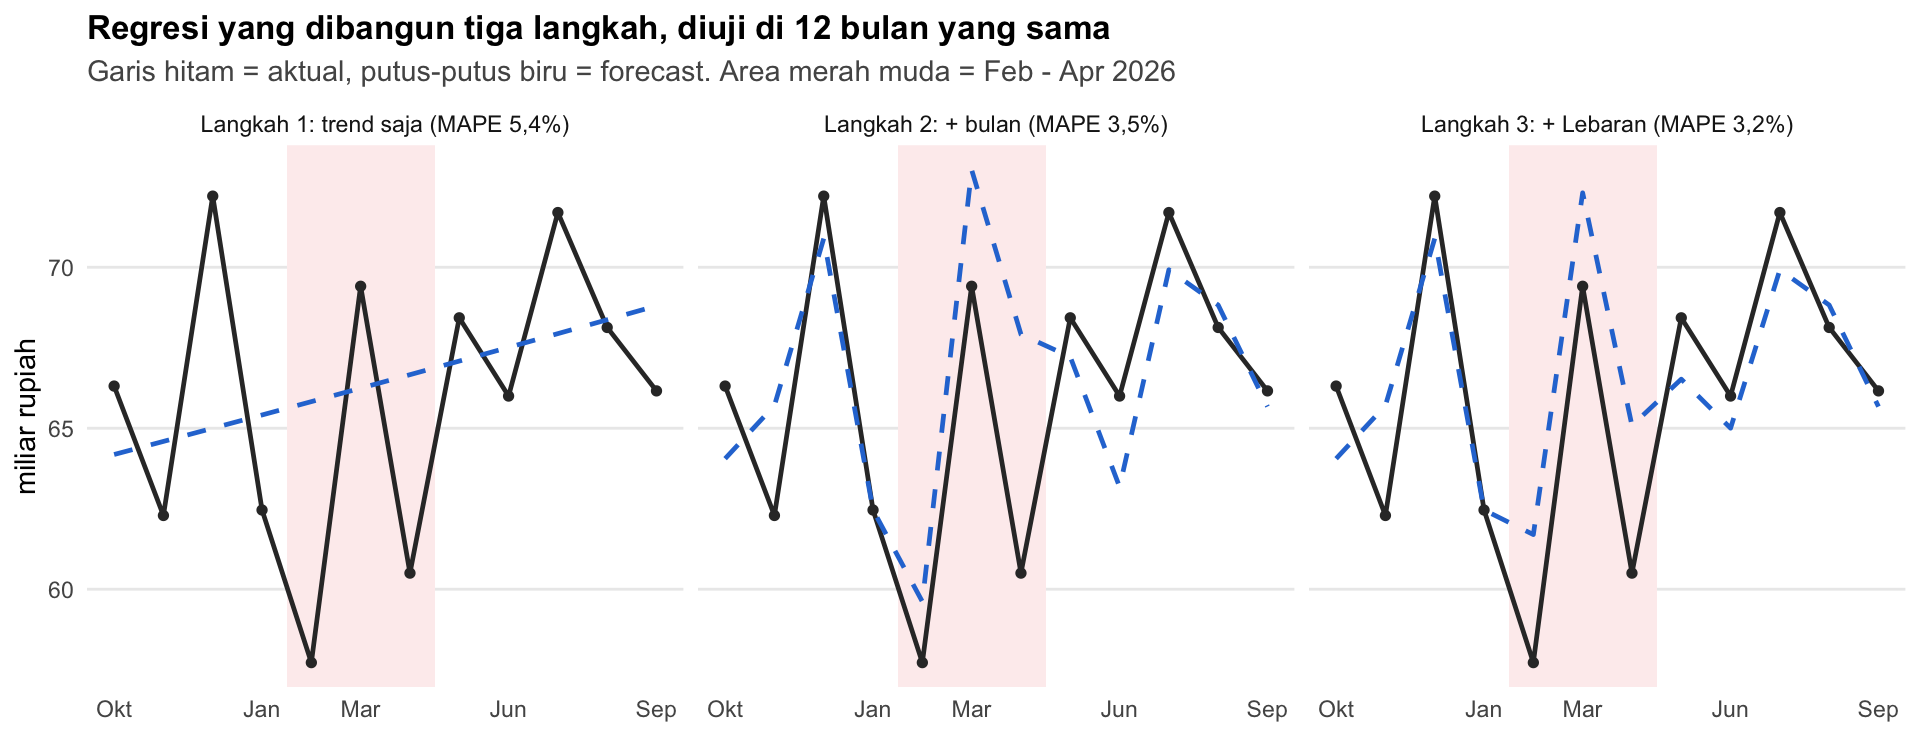
Semua langkah diuji di 12 bulan yang sama (Oktober 2025 sampai September 2026), memakai data latih Januari 2019 sampai September 2025 (81 bulan).
Langkah 1: Trend Saja
latih <- subset(bulanan, set == "training")
m1 <- lm(ln_sales ~ time_index + pandemic, data = latih)
| Koefisien | Artinya | |
|---|---|---|
b0 (intercept) |
3,64380 | |
b1 (waktu) |
0,00632 | Tumbuh exp(0,00632) - 1 = 0,63% per bulan, sekitar 7,9% per tahun |
b2 (pandemi) |
−0,13628 | Bulan pandemi 12,7% lebih rendah |
Contoh hitung manual untuk Oktober 2025 (indeks waktu = 82):
ln(F) = 3,64380 + 0,006317 x 82 = 4,16176
F     = exp(4,16176) = 64,18 miliar
MAPE: 5,4%. Garis lurus pun sudah mengalahkan cara lama (6,7%)! Tapi garisnya datar, padahal penjualan aslinya naik turun.
Langkah 2: Tambahkan Bulan
m2 <- lm(ln_sales ~ time_index + pandemic +
           Feb + Mar + Apr + May + Jun + Jul + Aug + Sep + Oct + Nov + Dec,
         data = latih)
Sekarang bentuk tahunannya muncul: Desember naik, Februari turun. MAPE turun menjadi 3,5%.
Tapi perhatikan koefisien Maret. Di langkah 2, Maret dianggap 15,5% lebih tinggi dari Januari. Kenapa setinggi itu? Karena Lebaran 2024 dan 2025 jatuh di bulan Maret, dan kolom Maret “menyerap” lonjakan Lebaran tersebut. Model jadi berharap setiap Maret akan selalu tinggi. Ini persis kesalahan yang sama dengan model time series tadi.
Langkah 3: Tambahkan Kolom Lebaran
Di sinilah triknya. Alih-alih membuat dummy “bulan Lebaran” (yang terbukti bermasalah di artikel nowcasting saya), kita menghitung jumlah hari yang terdampak di setiap bulan:
- Hari belanja: 20 hari, mulai H-21 sampai H-2 Lebaran. Kalau Ramadan panjangnya 29–30 hari, ini kira-kira dua pertiga terakhir bulan puasa, dari sekitar hari ke-10 sampai hari ke-29, saat orang berbelanja untuk persiapan Lebaran.
- Hari libur: 7 hari, mulai H-1 sampai H+5 Lebaran. Saat toko dan gudang tutup.
Contoh untuk Lebaran 20 Maret 2026:
| Bulan | Hari belanja | Hari libur |
|---|---|---|
| Februari 2026 | 2 | 0 |
| Maret 2026 | 18 | 7 |
Dan untuk tiga tahun:
| Mar 2025 | Apr 2025 | Feb 2026 | Mar 2026 | Apr 2026 | Feb 2027 | Mar 2027 | |
|---|---|---|---|---|---|---|---|
| Hari belanja | 20 | 0 | 2 | 18 | 0 | 12 | 8 |
| Hari libur | 2 | 5 | 0 | 7 | 0 | 0 | 7 |
Bagian terbaiknya: kedua kolom ini hanya butuh tanggal Lebaran. Artinya, kolom untuk tahun 2027 sudah bisa diisi dari sekarang. Bahkan untuk 2030 pun bisa — hanya perlu catatan bahwa tanggal 1 Syawal jauh ke depan masih bersifat perkiraan hisab, dan bisa bergeser sehari setelah sidang isbat. Menggeser satu hari berarti menggeser satu hari belanja, yang efeknya kecil dan bisa diperbarui begitu tanggal resminya keluar.
m3 <- lm(ln_sales ~ time_index + pandemic +
           Feb + Mar + Apr + May + Jun + Jul + Aug + Sep + Oct + Nov + Dec +
           lebaran_busy_days + lebaran_holiday_days,
         data = latih)
Hasilnya:
| Koefisien | Efek | |
|---|---|---|
| Tiap hari belanja | +0,01717 | +1,7% per hari |
| Tiap hari libur | −0,03581 | −3,5% per hari |
| Maret (vs Januari) | 0,07542 | +7,8% (turun dari 15,5% di langkah 2) |
Koefisien Maret menyusut menjadi separuhnya. Lonjakan Lebaran sudah “pindah” ke kolomnya sendiri, dan Maret kembali ke ukuran aslinya. MAPE turun lagi menjadi 3,2%.
Yang berubah dari langkah 2 hanyalah koefisien empat bulan, tepat bulan-bulan yang bisa disentuh Lebaran:
| Bulan | Langkah 2 | Langkah 3 |
|---|---|---|
| Maret | +15,5% | +7,8% |
| April | +6,7% | +2,3% |
| Mei | +4,9% | +3,9% |
| Juni | −2,0% | +0,9% |
| Februari | −5,2% | −5,2% |
Februari tidak bergerak sama sekali. Bukan karena kebetulan: di seluruh data latih, tidak ada satu pun Februari yang punya hari belanja. Yang punya hanya Februari 2026, dan itulah bagian yang belum pernah dilihat model.
Dua kolom baru itu juga terbukti memang dibutuhkan, bukan sekadar menambah variabel:
- Uji F dari langkah 2 ke langkah 3: F = 151 dengan derajat bebas (2, 65), p < 2,2 × 10⁻¹⁶.
- AIC turun dari −143,2 menjadi −279,5.
- Koefisien Maret turun dari 15,5% ke 7,8%, sesuai dugaan bahwa sebagian besar lonjakan Maret sebenarnya milik Lebaran.
Contoh hitung manual untuk Maret 2026 (waktu = 87, Maret = 1, belanja = 18, libur = 7):
ln(F) = 3,60103 + 0,006277 x 87 + 0,07542 + 18 x 0,01717 - 7 x 0,03581
F     = 72,31 miliar   (aktual 69,41)
Bandingkan dengan cara lama yang menebak 88,30 miliar. Not bad lah ya.
Papan Skor
Sekarang mari kita kumpulkan semua metode di satu papan skor, termasuk tiga model time series yang saya coba: Seasonal naive, ETS, dan Auto ARIMA. Seasonal naive saya sertakan sebagai pembanding paling dasar — ia hanya menyalin angka dari 12 bulan sebelumnya, tanpa belajar apa pun.
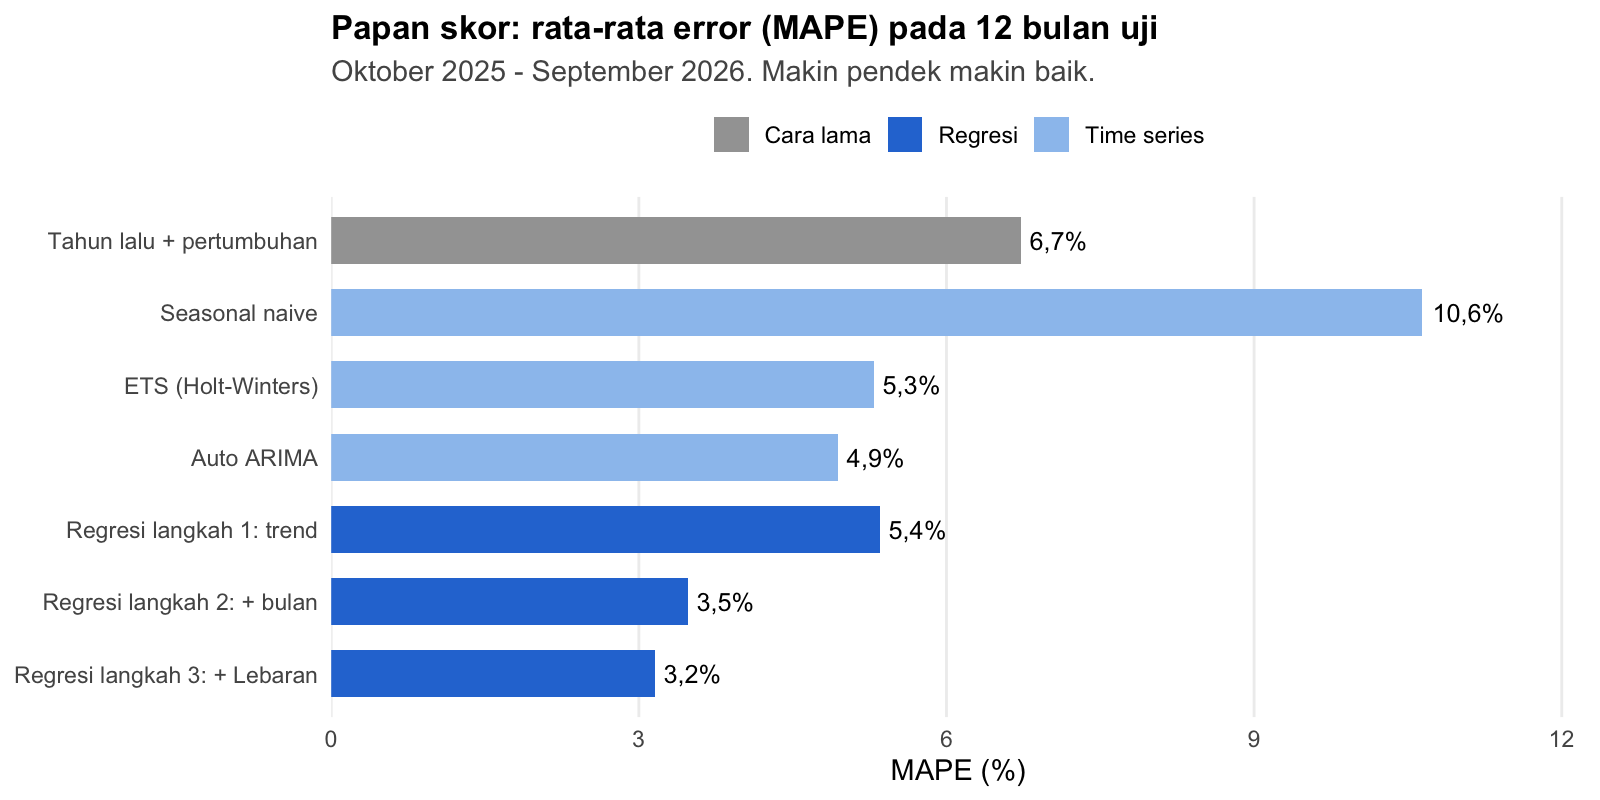
Untuk metode-metode di materi, berikut ukuran lainnya:
| Metode | MAE (miliar Rp) | RMSE (miliar Rp) | MAPE | R² |
|---|---|---|---|---|
| Tahun lalu + pertumbuhan | 4,46 | 6,75 | 6,7% | −1,50 |
| Langkah 1: trend saja | 3,46 | 4,18 | 5,4% | 0,04 |
| Langkah 2: + bulan | 2,24 | 2,94 | 3,5% | 0,53 |
| Langkah 3: + Lebaran | 2,03 | 2,45 | 3,2% | 0,67 |
Beberapa catatan:
- Semua ukuran sepakat: setiap langkah lebih baik dari langkah sebelumnya. Kesalahan turun dari 6,7% menjadi 3,2%, lebih dari setengahnya, tanpa tambahan sumber data baru sama sekali. Hanya tanggal Lebaran.
- R² cara lama bernilai negatif (−1,50). Perlu dijelaskan sedikit, karena R² negatif sering membingungkan. R² mengukur galat kuadrat, dan pembandingnya adalah rata-rata data uji (65,9 miliar). Nilai negatif berarti rumus “tahun lalu + pertumbuhan” menghasilkan galat kuadrat yang lebih besar daripada sekadar menebak 65,9 miliar setiap bulan. Kebetulan MAE-nya juga kalah (4,46 berbanding 3,46 miliar untuk langkah 1), jadi kesimpulannya sama saja mau diukur dengan cara apa pun.
- Hati-hati dengan R² di data latih. Kalau kita lihat
summary(m3), R²-nya 0,97. Tapi di data uji hanya 0,67. Selalu nilai model di data yang belum pernah dilihat oleh model. Ini sejalan dengan pesan moral di tulisan saya tentang failure formulas: jangan terobsesi dengan R² yang hampir 1. - Auto ARIMA (4,9%) memang lebih baik dari regresi langkah 1 (5,4%), tapi kalah dari regresi yang tahu kapan Lebaran datang. ETS (5,3%) juga lebih baik dari langkah 1, meski hanya tipis. Yang paling jauh di belakang adalah Seasonal naive (10,6%) — menyalin tahun lalu tanpa koreksi apa pun ternyata paling rawan.
- Pembandingnya bukan hanya “cara lama”. Regresi langkah 1 pun sudah mengalahkan cara lama (5,4% berbanding 6,7%). Jadi sebagian perbaikan datang hanya dari memakai garis tren, bukan dari kolom Lebaran. Yang benar-benar disumbangkan kolom Lebaran adalah langkah 2 ke langkah 3: 3,5% menjadi 3,2%.
Kalau Cuma 3,5% ke 3,2%, Kenapa Repot?
Ini pertanyaan yang wajar, dan saya sempat mengalaminya sendiri. Kemenangan langkah 3 pada 12 bulan uji memang terlihat tipis. Tapi lihat dari mana selisih itu datang:
| Bulan | Aktual | Error langkah 2 | Error langkah 3 |
|---|---|---|---|
| Februari 2026 | 57,72 | +3,3% | +6,9% |
| Maret 2026 | 69,41 | +5,2% | +4,2% |
| April 2026 | 60,50 | +12,3% | +7,6% |
| Mei 2026 | 68,43 | −1,8% | −2,8% |
| Juni 2026 | 66,00 | −4,3% | −1,5% |
| 7 bulan lainnya | identik | identik |
Tiga hal yang perlu dicatat:
- 2026 adalah tahun Lebaran yang “jinak”. Delapan belas dari 20 hari belanja, dan seluruh 7 hari libur, jatuh di bulan yang sama: Maret. Keduanya saling meredam, sehingga efek bersihnya hanya sekitar +6%. Kolom Lebaran jadi tidak punya banyak ruang untuk menunjukkan diri.
- Di Februari, langkah 3 justru lebih buruk (3,3% menjadi 6,9%). Model mengharapkan lonjakan dari 2 hari belanja yang jatuh di akhir Februari, dan lonjakan itu tidak terjadi. Ini konsekuensi jujur dari model yang menganggap setiap hari belanja setara.
- Keunggulannya muncul justru di bulan yang paling parah. Di April, kesalahan turun dari 12,3% menjadi 7,6%. Penurunan satu bulan itu saja (−4,7 poin persen, atau −0,39 poin pada MAPE) sebenarnya lebih besar daripada total perbaikan akhirnya (−0,32 poin). Sisanya termakan oleh kemunduran di Februari. Di Juni juga membaik (4,3% menjadi 1,5%).
Jadi kalau diukur pada 2026, keuntungannya memang sederhana. Yang dibayar mahal justru tahun berikutnya, ketika hari belanja dan hari libur jatuh di dua bulan berbeda. Itu bagian yang akan kita lihat di bagian forecast 2027.
Membaca Apa yang Dipelajari Model
Salah satu kelebihan regresi dibandingkan model time series (apalagi LSTM) adalah: koefisiennya bisa diceritakan ke manajemen.
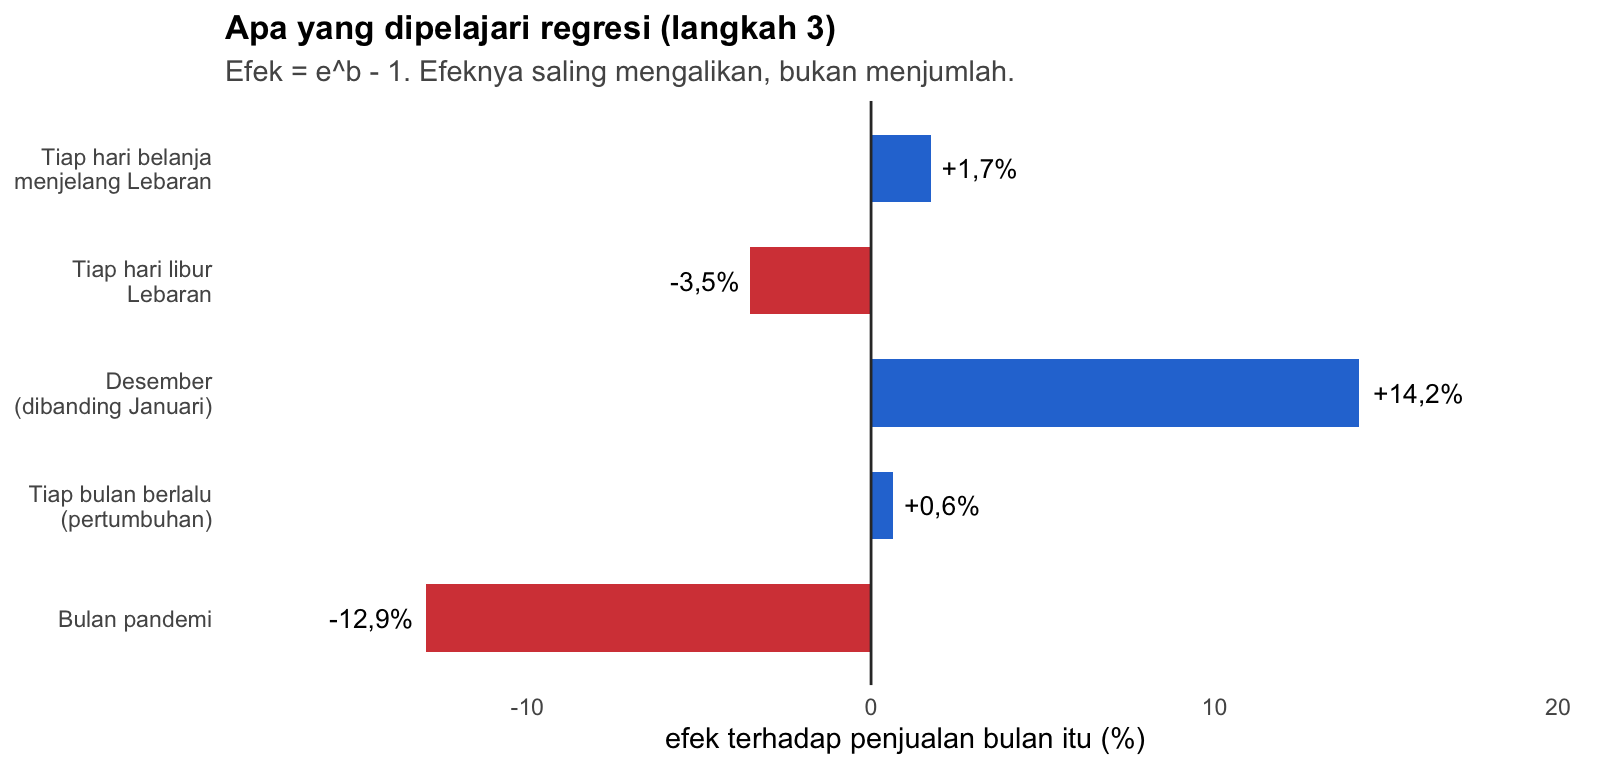
Satu hal yang perlu diingat: karena kita memakai ln, efeknya saling mengalikan, bukan menjumlahkan.
- 18 hari belanja:
exp(18 x 0,0172)= ×1,36 (naik 36%) - 7 hari libur:
exp(7 x -0,0358)= ×0,78 (turun 22%) - Efek bersih Lebaran di Maret 2026: 1,36 × 0,78 = ×1,06, sekitar +6% di atas Maret normal.
Ini juga menjelaskan kenapa Lebaran di tengah bulan tidak terlalu “meledak”: efek belanja dan efek libur terjadi di bulan yang sama sehingga saling meredam. Sebaliknya, kalau hari belanja dan hari libur terpisah di dua bulan berbeda, bulan pertama akan melonjak tinggi dan bulan berikutnya anjlok. Itulah yang terjadi di Maret dan April 2025.
Forecast 2027: Jangan Lupa Rentangnya
Untuk budget yang sesungguhnya, model langkah 3 di-_fit_ ulang dengan seluruh 93 bulan data, lalu dipakai untuk memprediksi Oktober 2026 sampai September 2027.
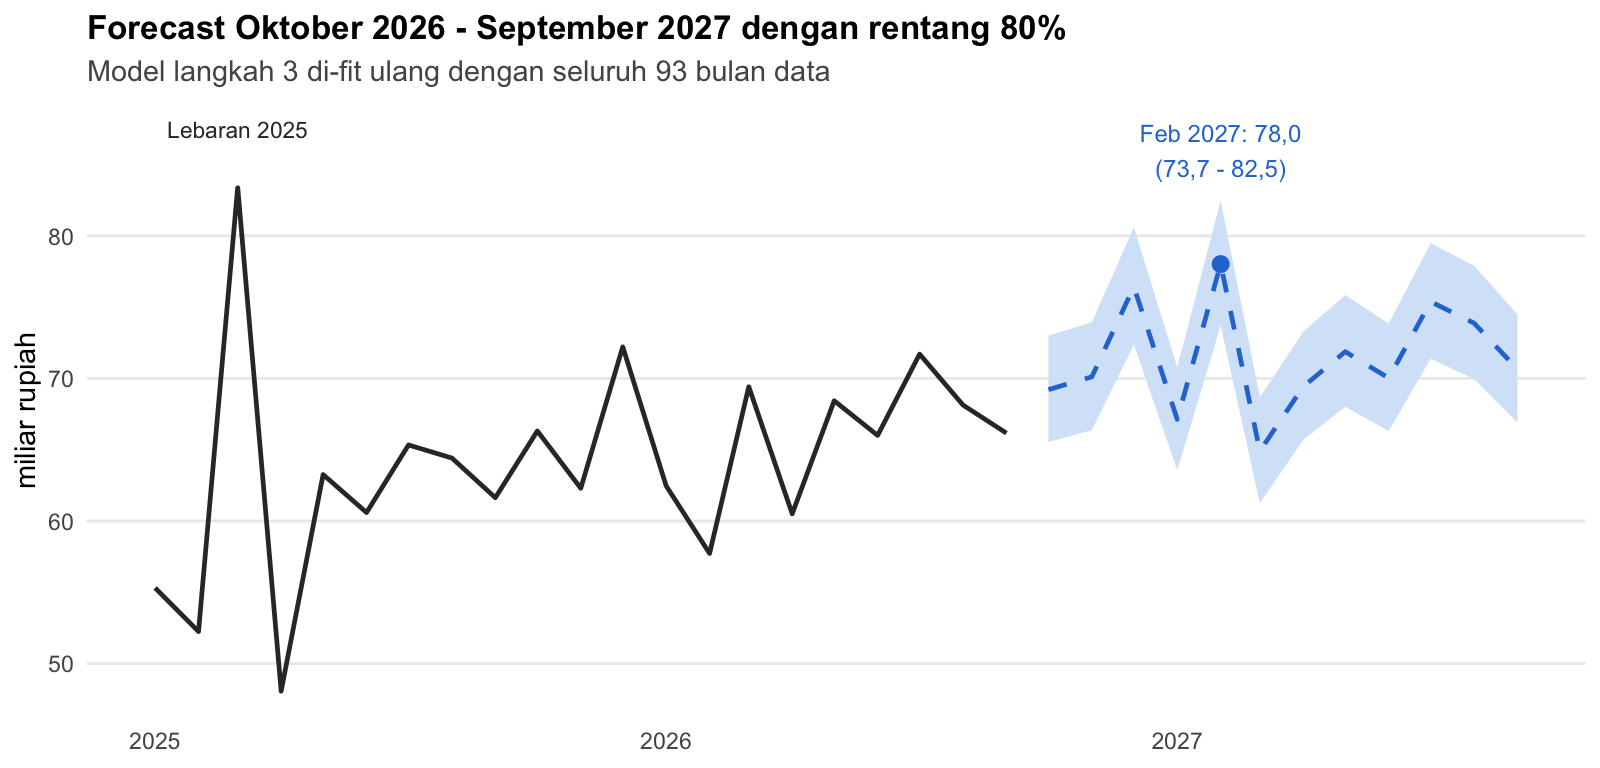
Puncak tahun depan diprediksi jatuh di Februari 2027: 78,0 miliar, dengan rentang 80% antara 73,7 sampai 82,5 miliar.
Sebelum lanjut, satu hal perlu dinyatakan terang-terangan. Puncak di Februari itu bukan hasil pengamatan, melainkan ekstrapolasi. Di seluruh data latih ada tujuh bulan Februari, dan tidak satu pun yang punya hari belanja. Februari 2027 akan memuat 12 hari belanja, jauh lebih banyak daripada Februari mana pun di data — paling banyak hanya 2 hari, itu pun di Februari 2026.
Artinya, model sedang menjawab pertanyaan yang belum pernah muncul di data: “kalau hari belanja jatuh di Februari, sebesar apa naiknya?” Arahnya masuk akal, dan koefisiennya stabil (kita uji lagi di bagian berikutnya), tapi tetap ini asumsi lintas bulan, bukan sesuatu yang sudah terbukti. Kalau nanti ternyata orang tidak berbelanja seantusias itu di bulan yang belum biasa, angka Februari akan terlalu tinggi — dan angka Maret akan terlalu rendah.
Dari mana rentang 73,7–82,5 itu? Bayangkan perjalanan ke kantor. Biasanya butuh 40 menit, dan di hari biasa meleset sekitar 5 menit. Lima menit itu adalah standard error, yaitu “meleset yang wajar”. Supaya tepat waktu 8 dari 10 hari, kita perlu menyiapkan waktu 40 ± 1,3 × 5 menit, yaitu 33,5 sampai 46,5 menit.
Forecast bekerja dengan cara yang sama persis:
- Meleset yang wajar untuk Februari 2027 sekitar 4,3% dari 78,0, yaitu sekitar 3,4 miliar.
- Untuk keyakinan 80%, kita perlu sekitar 1,29 kali meleset yang wajar. Angka ini berasal dari distribusi t dengan derajat bebas 93 − 16 = 77 (
qt(0.90, df = 77)di R, atau=T.INV(0.9, 77)di Excel). - Rentangnya: 78,0 − 4,4 sampai 78,0 + 4,4, yaitu 73,7 sampai 82,5 miliar.
Kalau diperhatikan, rentang itu tidak persis simetris terhadap 78,0: batas bawahnya berjarak 4,3 miliar, batas atasnya 4,4 miliar. Itu bukan salah hitung. Modelnya bekerja di skala log, dan setelah dikembalikan ke rupiah, jarak ke bawah dan ke atas tidak lagi sama. Karena itu di tulisan ini saya selalu menulis rentangnya apa adanya, bukan dalam bentuk “±”.
| Keyakinan | Pengali | Rentang Februari 2027 |
|---|---|---|
| 68% | 1,00 | 74,7 – 81,4 |
| 80% | 1,29 | 73,7 – 82,5 |
| 95% | 1,99 | 71,5 – 85,0 |
Perhatikan baris terakhir. Bahkan pada keyakinan 95%, rentangnya masih 71,5 sampai 85,0 miliar — kurang dari 20% dari nilai tengahnya. Untuk keperluan penyusunan anggaran, itu masih sangat bisa dipakai. Kalau rentangnya sudah menyebar sampai dua kali lipat, barulah kita perlu curiga modelnya terlalu rapuh untuk dijadikan dasar keputusan.
Pesan moralnya sama dengan kasus banjir Red River di tulisan failure formulas: komunikasikan forecast beserta rentangnya, bukan hanya garis tengahnya. Hal yang sama sudah saya rasakan juga saat menulis tentang Bayesian time series: range lebih jujur daripada single point.
Kenapa Langkah 3 Benar-Benar Penting?
Mari bandingkan forecast 2027 dari model langkah 2 (tanpa kolom Lebaran) dan langkah 3 (dengan kolom Lebaran):
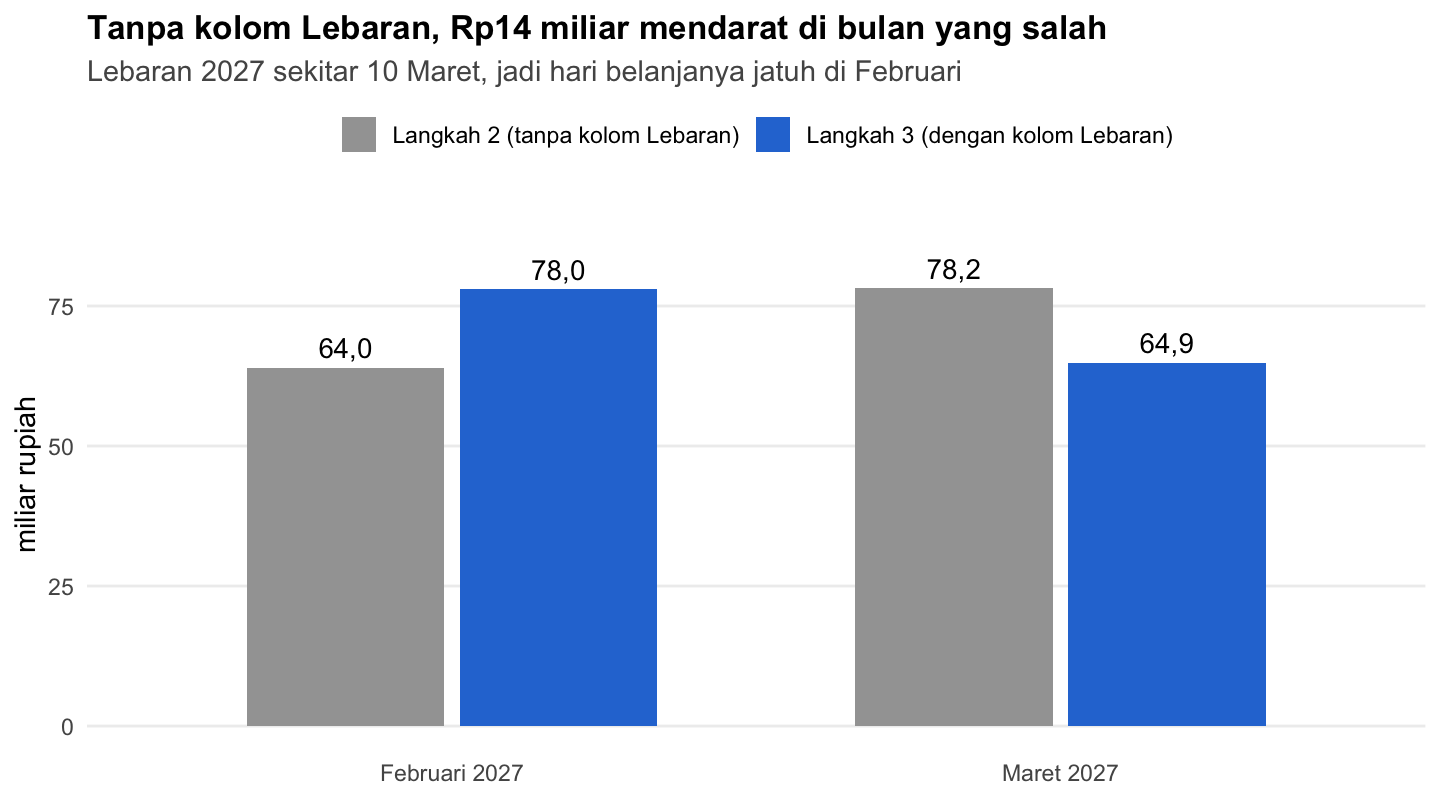
Total keduanya hampir sama. Tapi bulannya tertukar!
- Model tanpa kolom Lebaran berpikir: “Maret itu bulan tinggi, karena dua tahun terakhir Lebaran jatuh di Maret.”
- Model dengan kolom Lebaran berpikir: “Lebaran 2027 sekitar 10 Maret, jadi 12 dari 20 hari belanjanya jatuh di Februari. Maret justru kena 7 hari libur.”
Selisihnya sekitar 14 miliar rupiah yang mendarat di bulan yang salah. Dalam praktiknya, ini berarti stok, tenaga kerja, dan kas harus siap sebulan lebih awal dibandingkan tahun lalu. Kalau budget disusun dengan cara lama, gudang akan penuh di bulan Maret saat permintaan sudah lewat, dan kosong di bulan Februari saat orang sedang ramai berbelanja.
Kesimpulannya Bertahan Walau Modelnya Diutak-atik
Ada satu pemeriksaan yang belum saya lakukan dan seharusnya tidak dilewati. Regresi linear biasa mengasumsikan sisa model tidak saling terikat antar bulan. Pada data bulanan, asumsi ini sering patah — dan di sini memang patah.
Uji Ljung-Box pada sisa langkah 3 (lag 12) memberi p = 0,0008, dengan autokorelasi yang masih terlihat di lag 1 (0,31) dan lag 3 (0,25). Artinya, masih ada pola yang belum tertangkap model. Ini konsekuensi wajar dari memakai regresi untuk data yang berurutan waktu.
Pertanyaannya: apakah ini mengubah kesimpulan? Saya jawab dengan cara yang sama seperti di tulisan tentang hujan dan warung: utak-atik modelnya, lalu lihat apakah angkanya bergerak.
Model pembandingnya AR(1) dengan kolom yang persis sama, dilatih pada 81 bulan yang sama:
| Langkah 3 (regresi biasa) | AR(1) + kolom yang sama | |
|---|---|---|
| Tiap hari belanja | +0,0172 | +0,0176 |
| Tiap hari libur | −0,0358 | −0,0357 |
| Maret (vs Januari) | 0,0754 | 0,0732 |
| AIC | −279,5 | −286,7 |
Arah dan besarnya hampir tidak bergerak, dan menurut AIC model AR(1) justru sedikit lebih baik. Hasil ramalan Februari 2027-nya pun nyaris sama:
| Model | Ramalan Feb 2027 | Rentang 80% |
|---|---|---|
| Langkah 3 (regresi biasa) | 78,0 | 73,7 – 82,5 |
| AR(1) + kolom yang sama | 78,5 | 74,7 – 82,5 |
Selisih setengah miliar pada nilai tengah, dan batas atasnya sama persis. Untuk keperluan budget, keduanya memberi pesan yang identik.
Kalau sebuah kesimpulan berubah hanya karena cara menulis modelnya diganti, itu tandanya kesimpulan tersebut rapuh.
Di sini kesimpulannya tidak berubah. Yang tersisa adalah asumsi-asumsi yang tidak bisa diuji dengan data yang ada — soal Februari 2027 tadi, dan beberapa lagi. Semuanya saya catat di bagian limitasi.
Jadi, Apa Bedanya dengan Cara Saya Selama Ini?
Kalau saya rangkum, inilah perbedaan mendasar antara cara saya membuat forecast di artikel-artikel sebelumnya dengan cara di tulisan ini:
| Aspek | Cara saya selama ini | Cara di tulisan ini |
|---|---|---|
| Keluarga model | Time series: dekomposisi, ARIMA, ETS, Prophet, LSTM, BSTS | Regresi linear dengan kolom yang dirakit sendiri |
| Cara pandang musiman | Pola yang menempel di bulan kalender, berulang tiap tahun | Musiman kalender dipisah dari efek kalender Hijriah |
| Cara memasukkan Lebaran | Tidak dimasukkan, atau dummy “bulan Lebaran” (0/1) yang bertabrakan dengan dummy bulan | Jumlah hari belanja dan libur di setiap bulan, dihitung dari tanggal Lebaran |
| Lebaran yang terbelah dua bulan | Tidak tertangani | Tertangani otomatis, karena hari dihitung per bulan |
| Input masa depan | Tidak perlu (model hanya melihat masa lalu) | Perlu, tapi cukup tanggal Lebaran yang sudah diketahui jauh-jauh hari |
| Cara menguji | Sering di data latih, atau visual (korelasi, MAE in-sample) | 12 bulan uji yang tidak pernah dilihat model, dari posisi yang sama dengan saat budgeting |
| Interpretasi | Sulit diceritakan (terutama LSTM) | Setiap koefisien bisa dibaca sebagai persen: “tiap hari belanja menambah 1,7%” |
| Output | Seringnya satu angka | Angka + rentang 80% |
Satu hal yang perlu saya luruskan: tulisan ini bukan berarti time series itu jelek. Untuk data tanpa hari raya bergerak (misalnya harga emas harian), model time series tetap sangat masuk akal. Yang saya pelajari adalah: kalau ada pola yang kita tahu penyebabnya dan kita tahu kapan ia akan terjadi, jangan suruh model menebaknya dari pola masa lalu. Beri tahu model secara eksplisit.
Sebenarnya ide yang sama bisa dibawa kembali ke dunia time series. Misalnya:
- ARIMA dengan variabel eksternal (
auto.arima(y, xreg = ...)), dengan kolom hari belanja dan hari libur yang sama sebagaixreg. - Prophet dengan tabel holidays yang diberi
lower_window = -21danupper_window = 5, sehingga Lebaran tidak lagi dianggap satu hari, melainkan satu jendela waktu.
Kuncinya tetap sama: ubah tanggal Lebaran menjadi jumlah hari terdampak. Mungkin ini akan jadi bahan tulisan saya berikutnya.
Epilog
Limitasi
Sebelum menutup, saya rasa penting untuk jujur soal limitasi dari analisa ini:
- Datanya fiktif, walaupun tanggal Lebarannya asli. Besarnya efek (+1,7% per hari belanja, −3,5% per hari libur) akan berbeda untuk setiap kategori produk dan setiap perusahaan.
- Definisi jendela belanja (H-21 s.d. H-2) dan libur (H-1 s.d. H+5) adalah asumsi. Untuk kategori seperti sirup atau biskuit kaleng, jendela belanjanya mungkin lebih panjang. Sebaiknya jendela ini diuji dengan beberapa alternatif.
- Efek per hari diasumsikan sama. Padahal belanja di H-3 mungkin jauh lebih ramai dibandingkan H-20. Pembobotan per hari bisa jadi pengembangan berikutnya.
- Ramalan Februari 2027 adalah ekstrapolasi lintas bulan. Dari tujuh Februari di data latih, tidak satu pun memuat hari belanja. Jadi efek 12 hari belanja itu diterapkan ke bulan yang belum pernah punya preseden. Angkanya sebaiknya dibaca sebagai perkiraan yang arahnya masuk akal, bukan sebagai hasil pengamatan.
- Data latihnya pendek, dan dua Lebaran jatuh di masa pandemi. Hanya ada 7 kali Lebaran di data latih, dan dua di antaranya (2020 dan 2021) terjadi saat pembatasan mobilitas. Lebaran 2020 bahkan seluruhnya terserap dummy pandemi, sehingga efeknya tidak bisa dipisahkan dari efek pandemi itu sendiri. Sisa terbesar model pun masih di sekitar masa itu.
- Yang ditemukan adalah hubungan, bukan sebab-akibat. Koefisien hari belanja menunjukkan pola yang konsisten dengan data, dan tahan ketika modelnya diganti. Tapi itu belum membuktikan bahwa menambah satu hari belanja menyebabkan kenaikan 1,7%. Untuk klaim sebab-akibat, kita butuh desain riset lain, misalnya eksperimen atau data tingkat toko.
- Model masih meleset di Maret 2026 (72,3 berbanding 69,4). Lebih baik dari cara lama, tapi belum sempurna. Wajar, karena memang tidak ada model yang sempurna.
Menuliskan limitasi bukan tanda analisanya lemah. Justru inilah yang membuat kesimpulannya layak dipakai untuk mengambil keputusan.
Selama bertahun-tahun, saya selalu mencoba “mengakali” model time series agar mau mengerti bulan puasa. Ternyata solusinya adalah melangkah mundur sedikit ke regresi linear biasa, lalu bertanya dengan pertanyaan yang lebih tepat:
Bukan “apakah bulan ini bulan Lebaran?”, tapi “berapa hari dari bulan ini yang terdampak Lebaran?”
Satu pertanyaan sederhana, dan kesalahan forecast turun dari 6,7% menjadi 3,2%.
Buat rekan-rekan yang sering membuat forecast penjualan di Indonesia, semoga tulisan ini bisa jadi titik awal yang berguna. Kolom yang sama juga bisa dipakai untuk momen bergerak lainnya, seperti Imlek, Idul Adha, atau awal tahun ajaran. Untuk yang tanggalnya benar-benar tetap — misalnya tanggal gajian — kolom bulan biasanya sudah cukup; yang perlu dihitung justru jumlah hari kerja di sekitar tanggal itu.
if you find this article helpful, support this blog by clicking the ads.