Survey 100 Orang Setiap Kuartal untuk Menilai Tim Marketing: Mengukur Kerja Keras atau Mengukur Keberuntungan?
Bayangkan situasi berikut ini.
Sebuah perusahaan rutin melakukan survey setiap kuartal untuk memantau berapa persen konsumen yang menjadi user dari brand X. Setiap kuartal, ada 100 orang responden yang diwawancarai. Dari buku statistik, kita tahu bahwa survey dengan 100 responden punya margin of error sekitar 10%.
Beberapa kuartal belakangan, hasilnya stabil: persentase user brand X selalu berada di kisaran 6% sampai 8%. Dengan logika yang sudah biasa kita pakai, kesimpulannya:
“Hasil survey 7%, margin of error 10%. Berarti persentase user di populasi berada di antara 0% sampai 18%.”
Lalu datanglah kebutuhan bisnis berikut:
“Tolong tentukan target persentase user kuartal depan. Kalau tim marketing tidak bisa mencapai target tersebut, mereka harus bekerja lebih giat lagi.”
Pertanyaannya: bagaimana cara menentukan target yang benar?
Pertanyaan ini kelihatannya sederhana. Tapi saat saya bedah, ternyata jawabannya tidak bisa berupa satu angka. Sebelum masuk ke detailnya, saya tuliskan dulu jawaban singkatnya.
Jawaban Singkat
Kalimat “kalau target tidak tercapai, tim harus bekerja lebih giat” sebenarnya mengandung tiga pertanyaan bisnis yang berbeda:
| # | Pertanyaan bisnis | Alat ukur yang tepat | Cara menetapkan target |
|---|---|---|---|
| 1 | Apakah brand kita tumbuh? | Survey tracking, dibaca per semester atau per tahun (bukan per kuartal) | Target berupa peluang: “minimal 90% yakin persentase user naik dibandingkan baseline” |
| 2 | Apakah tim marketing bekerja dengan baik? | KPI yang dikendalikan langsung oleh tim: eksekusi kampanye, jangkauan iklan, distribusi, trial, penjualan | Target angka bulanan atau kuartalan biasa, karena datanya cukup besar dan “tenang” |
| 3 | Apakah kampanye kita yang menyebabkan kenaikan? | Eksperimen: area yang mendapat kampanye vs area yang tidak (test vs control) | Target berupa besarnya efek kampanye dibandingkan kelompok pembanding |
Kesalahan di kasus brand X adalah memakai alat untuk pertanyaan nomor 1 (survey 100 orang per kuartal) untuk menjawab pertanyaan nomor 2 dan 3. Akibatnya, penilaian kinerja tim lebih banyak ditentukan oleh keberuntungan daripada oleh kerja keras.
Sisa tulisan ini adalah penjelasan lengkap kenapa jawabannya seperti itu. Alurnya:
- Membaca angka survey dengan benar. Angka margin of error 10% ternyata salah untuk brand X, dan ada cara yang lebih baik bernama interval Wilson.
- Kenapa survey 100 orang per kuartal tidak bisa jadi rapor tim. Dibuktikan lewat enam simulasi di R.
- Bagaimana dengan pendekatan Bayesian? Pendekatan yang saya pakai di pekerjaan saya, lengkap dengan jebakan-jebakannya.
- Kerangka tiga pertanyaan: apa yang harus dilakukan untuk masing-masing pertanyaan.
- Langkah praktis untuk brand X.
Semua datanya adalah simulasi (brand X fiktif), supaya kita bisa melihat dengan mata kepala sendiri apa yang terjadi di balik angka survey.
Bagian 1: Membaca Angka Survey dengan Benar
Dari mana angka margin of error 10% itu?
Rumus margin of error (MoE) yang biasa kita pakai adalah:
MoE = 1,96 x akar( p x (1 - p) / n )
dengan p adalah proporsi dan n adalah jumlah responden.
Saat merencanakan survey, kita belum tahu berapa nilai p. Maka kita pakai skenario terburuk, yaitu p = 50%. Di angka 50% inilah nilai p x (1 - p) paling besar, sehingga MoE-nya juga paling besar:
MoE = 1,96 x akar( 0,5 x 0,5 / 100 ) = 9,8% ≈ 10%
Dari sinilah angka “keramat” 10% itu berasal.
Tapi kalau kita memasukkan p = 7%, yaitu hasil survey brand X yang sebenarnya:
MoE = 1,96 x akar( 0,07 x 0,93 / 100 ) = 5,0%
MoE-nya tinggal separuh!
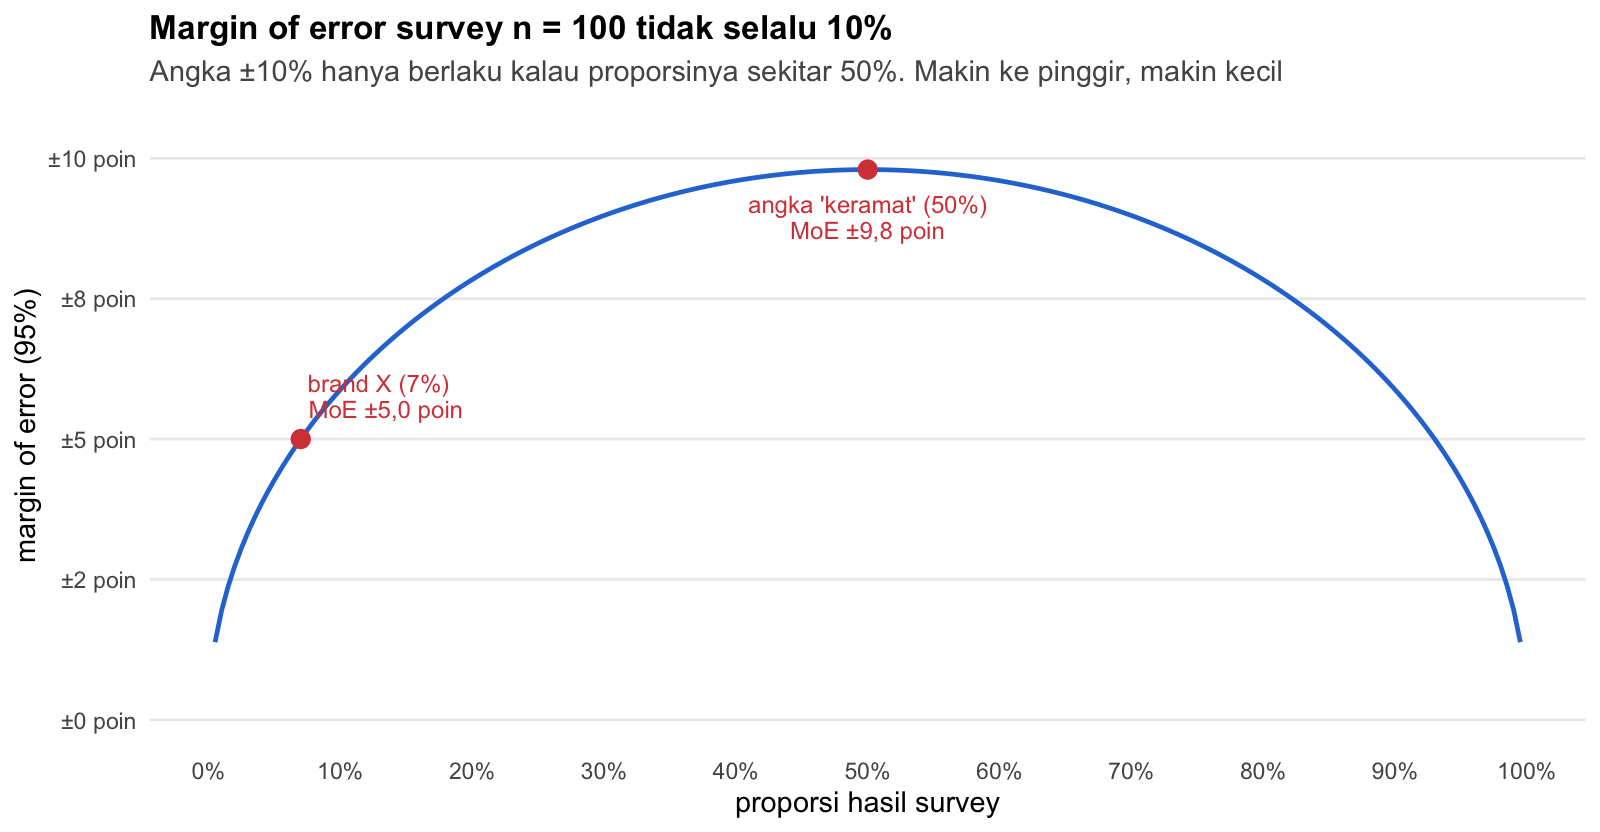
MoE berbentuk seperti “kubah”. Paling tinggi di 50%, lalu makin kecil saat proporsinya mendekati 0% atau 100%.
| Kegunaan | Angka MoE yang dipakai |
|---|---|
| Merencanakan survey (belum tahu hasilnya) | p = 50%, MoE ±10%. Wajar, karena menjamin MoE tidak akan lebih besar dari itu |
| Membaca hasil survey (sudah tahu hasilnya) | p hasil survey. Untuk brand X, MoE ±5% |
Kesalahan yang sering terjadi adalah memakai angka MoE dari tahap perencanaan untuk membaca hasil. Akibatnya, rentang 0%–18% tadi terlalu lebar. Dengan MoE ±5%, rentangnya menjadi 2%–12%. Sudah lebih baik, tapi masih ada masalah lain.
Rumus MoE biasa punya kelemahan di proporsi kecil
Rumus MoE tadi punya nama resmi: interval Wald. Rumus ini populer karena sederhana, tapi di proporsi kecil seperti brand X, ia punya dua kelemahan.
Kelemahan 1: bisa menghasilkan angka yang mustahil.
| Hasil survey | Interval Wald | Masalah |
|---|---|---|
| 7 dari 100 (7%) | 2,0% – 12,0% | Aman |
| 2 dari 100 (2%) | −0,7% – 4,7% | Persentase user negatif? Mustahil! |
| 0 dari 100 (0%) | 0% – 0% | Kita “yakin 100%” tidak ada satu pun user di seluruh populasi, hanya karena 100 orang yang kita tanya kebetulan bukan user? |
Penyebabnya ada dua:
- Interval Wald dipaksa simetris. Mundur 5 poin, maju 5 poin. Padahal di angka 7%, ruang ke bawah hanya tersisa 7 poin, sedangkan ruang ke atas masih 93 poin.
- Interval Wald menghitung ketidakpastian dari hasil survey itu sendiri, padahal hasil survey itu juga belum pasti. Kalau hasil survey 0%, maka
p x (1 - p) = 0, sehingga MoE-nya juga 0.
Kelemahan 2: sering “ingkar janji”.
Interval 95% punya janji: kalau survey diulang berkali-kali, 95% dari interval yang dihasilkan akan memuat nilai sebenarnya. Saya menghitung seberapa sering janji itu ditepati untuk berbagai nilai persentase user:
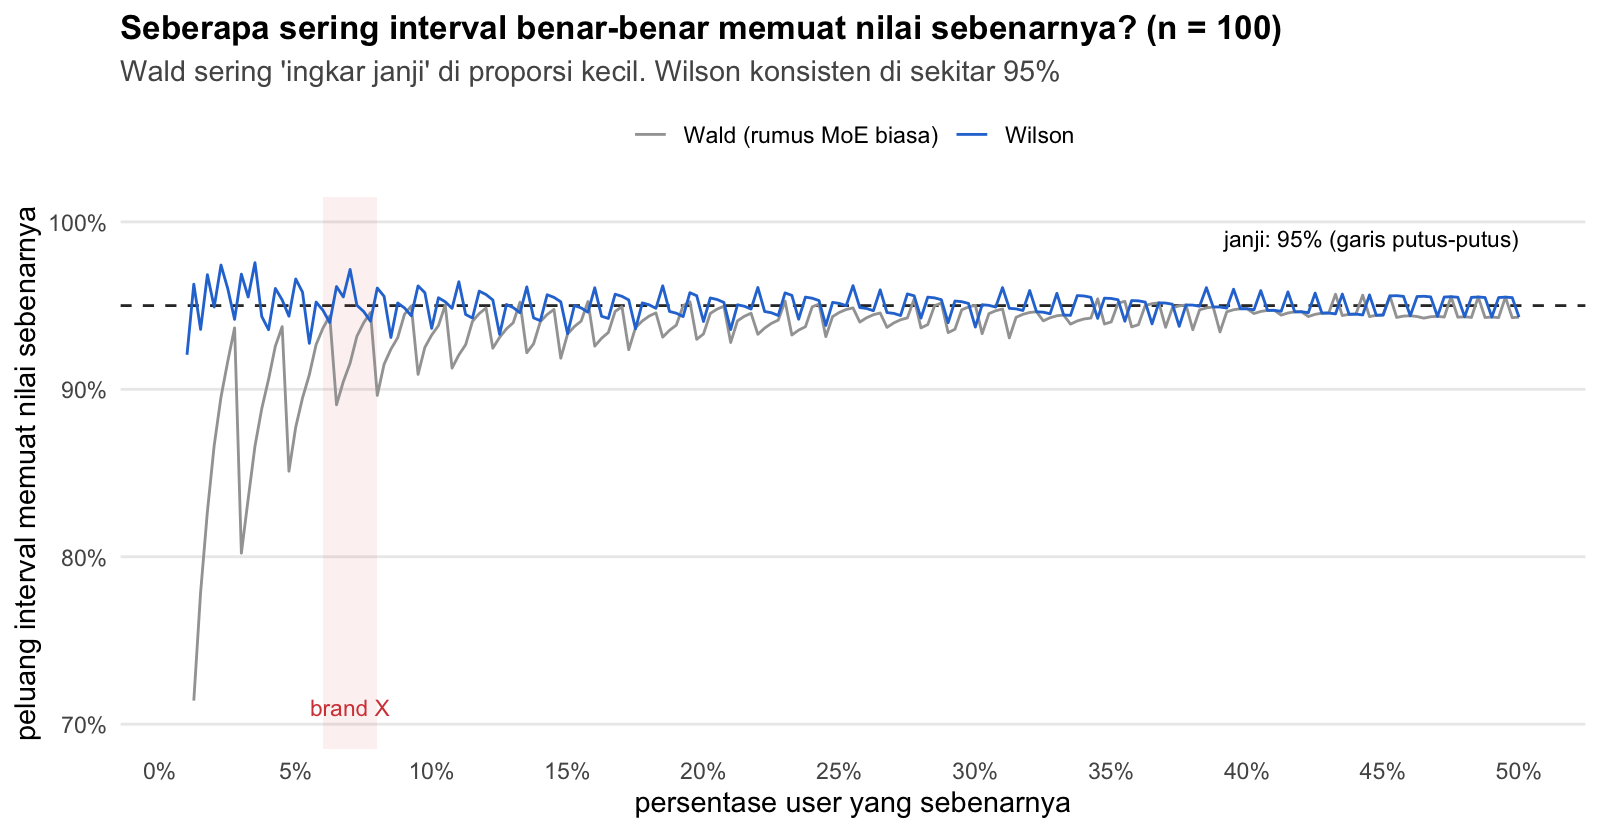
Di proporsi kecil, interval Wald (garis abu-abu) sering ingkar janji. Di beberapa titik, peluangnya memuat nilai sebenarnya hanya sekitar 80% atau bahkan di bawah 75%. Untuk brand X di angka 7%, interval Wald hanya menepati janji sekitar 91,6%. Garisnya zig-zag karena hasil survey selalu berupa bilangan bulat (7 orang, 8 orang, bukan 7,3 orang).
Ada aturan praktis kapan interval Wald boleh dipakai: n x p minimal 10 dan n x (1 - p) minimal 10. Untuk brand X: 100 x 7% = 7. Syaratnya tidak terpenuhi.
Interval Wilson: membalik pertanyaannya
Saya suka menjelaskan perbedaan Wald dan Wilson dengan analogi detektif.
Interval Wald bertanya:
“Saya dapat hasil 7%. Kalau saya mundur dan maju sekian poin, rentangnya dari mana sampai mana?”
Interval Wilson membalik pertanyaannya:
“Saya dapat hasil 7%. Dari semua kemungkinan persentase user di populasi, mana saja yang ‘alibinya’ masih masuk akal untuk menghasilkan angka 7% di survey saya?”
Seperti detektif yang memeriksa daftar tersangka satu per satu. Populasi dengan 30% user menghasilkan survey 7%? Rasanya tidak, coret. Populasi dengan 10% user? Masih masuk akal, tetap di daftar. Populasi dengan 1% user? Rasanya tidak, coret.
Kumpulan “tersangka” yang lolos pemeriksaan inilah interval Wilson. Kuncinya: saat memeriksa setiap tersangka, Wilson menghitung ketidakpastian berdasarkan nilai tersangka tersebut, bukan berdasarkan hasil survey. Karena itulah Wilson tidak “tertipu” saat hasil survey-nya 0%.
Secara matematis, Wilson mencari semua nilai p yang memenuhi:
dengan adalah hasil survey. Kalau persamaan kuadrat ini diselesaikan:
Tidak perlu dihafal. Yang penting dipahami ada dua sifatnya:
- Pusatnya bergeser sedikit ke arah 50%, sehingga intervalnya tidak simetris. Di angka 7%, rentang ke atas lebih panjang dari rentang ke bawah.
- Hasilnya selalu berada di antara 0% dan 100%.
Contoh hitung manual untuk brand X (7 dari 100 orang, z = 1,96):
z^2         = 3,8416
z^2 / n     = 0,0384

Pusat = (0,07 + 0,0192) / 1,0384 = 0,0859  →  8,59%
Lebar = (1,96 / 1,0384) x akar(0,000651 + 0,000096)
      = 1,8875 x 0,02733 = 0,0516            →  5,16%

Interval Wilson = 8,59% ± 5,16% = 3,4% sampai 13,8%
| Cara | Rentang persentase user brand X |
|---|---|
| MoE “keramat” 10% | 0% – 18% |
Interval Wald dengan p hasil survey |
2,0% – 12,0% |
| Interval Wilson | 3,4% – 13,8% |
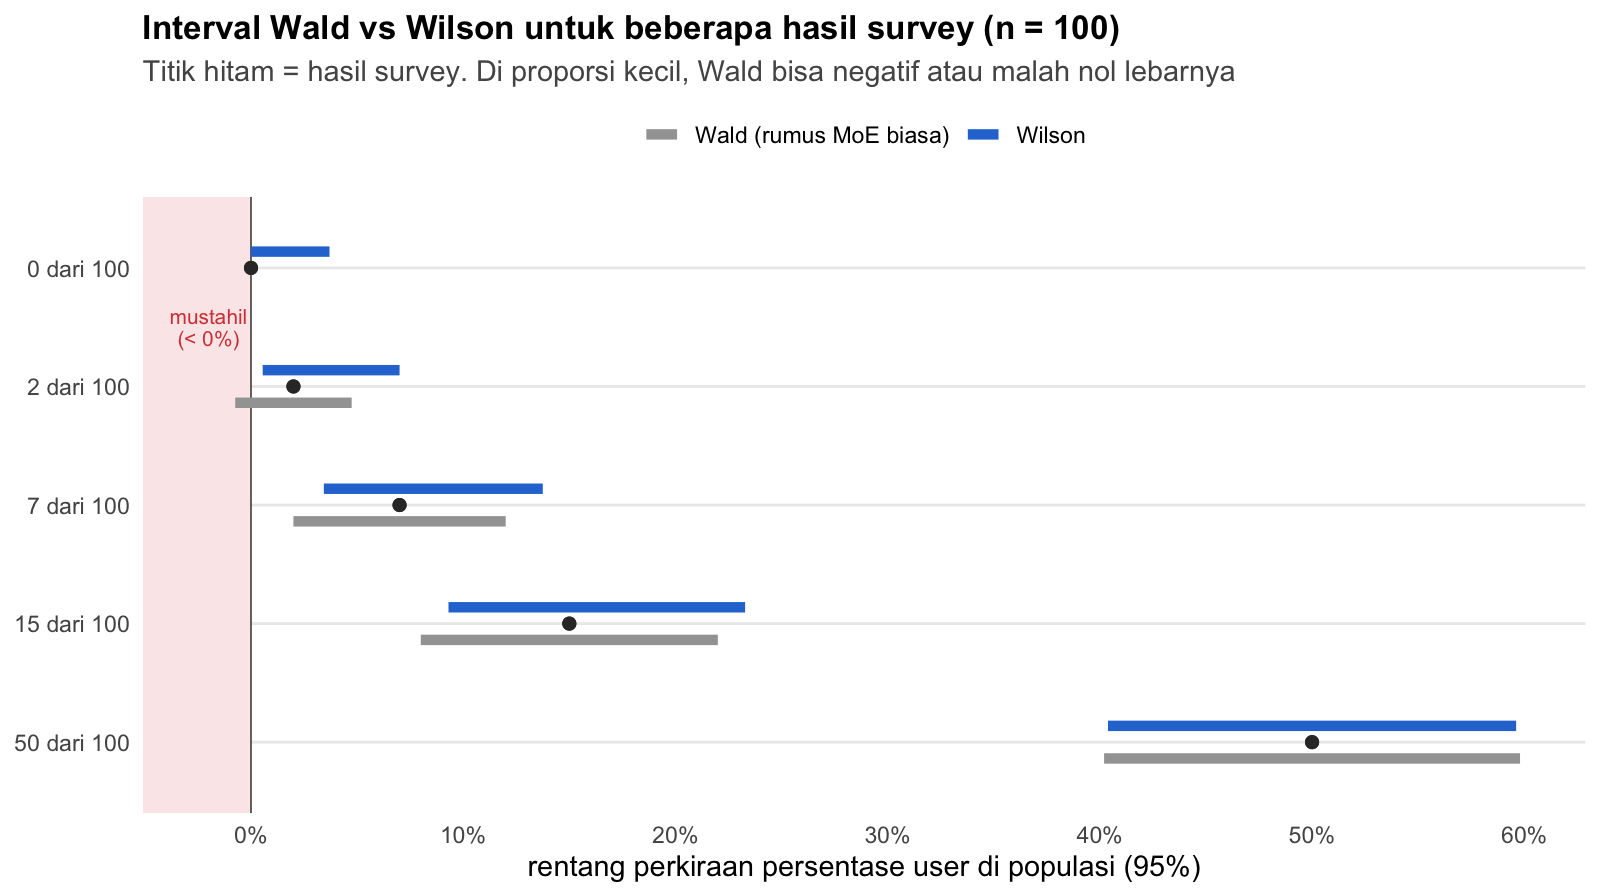
Perhatikan baris “0 dari 100”. Interval Wald (abu-abu) tidak muncul karena lebarnya nol, sedangkan Wilson tetap memberikan rentang 0% – 3,7%. Di grafik coverage sebelumnya, Wilson (garis biru) juga konsisten di sekitar 95%, sesuai janjinya.
Cara memakai interval Wilson
Di R, interval Wilson sudah tersedia lewat prop.test() (pastikan correct = FALSE):
prop.test(7, 100, correct = FALSE)$conf.int
# [1] 0.03431926 0.13749515
Atau buat fungsinya sendiri supaya lebih paham:
wilson <- function(x, n, z = 1.96) {
  p <- x / n
  pusat <- (p + z^2 / (2 * n)) / (1 + z^2 / n)
  lebar <- z / (1 + z^2 / n) * sqrt(p * (1 - p) / n + z^2 / (4 * n^2))
  c(bawah = pusat - lebar, atas = pusat + lebar)
}

wilson(7, 100)
#      bawah       atas
# 0.03431882 0.13749671
Di Python:
from statsmodels.stats.proportion import proportion_confint
proportion_confint(7, 100, alpha = 0.05, method = "wilson")
Di Excel, misalkan proporsi ada di sel B1 dan jumlah responden di sel B2:
Bawah: =(B1+1.96^2/(2*B2)-1.96*SQRT(B1*(1-B1)/B2+1.96^2/(4*B2^2)))/(1+1.96^2/B2)
Atas : =(B1+1.96^2/(2*B2)+1.96*SQRT(B1*(1-B1)/B2+1.96^2/(4*B2^2)))/(1+1.96^2/B2)
Asumsi dan limitasi interval Wilson
Wilson bukan obat segala penyakit. Asumsinya sama persis dengan rumus MoE biasa:
- Responden dipilih secara acak sederhana (simple random sampling).
- Jawaban responden saling bebas. Tidak ada pengelompokan, misalnya beberapa responden dari satu rumah atau satu RT.
- Jawabannya hanya dua kemungkinan: user atau bukan user.
- Populasinya jauh lebih besar dari sampel (sampel kurang dari sekitar 5% populasi).
Limitasinya:
- Hanya menangkap kesalahan karena “kebetulan memilih orang” (sampling error). Pertanyaan yang membingungkan, responden yang menolak diwawancara, responden yang menjawab asal, atau daftar calon responden yang tidak mewakili populasi tidak tercakup. Hal ini pernah saya bahas di tulisan Angkanya Turun, tapi yang Turun Apa?.
- Desain survey yang rumit membuat interval lebih lebar. Kalau survey memakai kuota, cluster, atau pembobotan, pakai ukuran sampel efektif
n_efektif = n / deff. Nilaideff(design effect) survey konsumen biasanya 1,2 sampai 2. Dengandeff = 1,5, 100 responden setara dengan sekitar 67 responden acak. - Wilson tetap sebuah pendekatan. Garis Wilson di grafik coverage juga bergerigi, kadang sedikit di atas atau di bawah 95%. Tapi secara rata-rata jauh lebih menepati janji dibandingkan Wald. Brown, Cai, dan DasGupta (2001) merekomendasikan Wilson sebagai salah satu interval terbaik untuk proporsi.
- Ada alternatif lain: Clopper-Pearson (dijamin minimal 95% tapi terlalu lebar), Agresti-Coull (lebih sederhana, hasilnya mirip Wilson), dan Jeffreys (pendekatan Bayesian, performanya mirip Wilson).
- Hati-hati membacanya. Interval 95% tidak berarti “ada peluang 95% nilai sebenarnya berada di rentang ini”. Artinya: kalau survey diulang berkali-kali, 95% dari interval yang dihasilkan akan memuat nilai sebenarnya.
Manfaatkan data beberapa kuartal sekaligus
Hasil survey brand X beberapa kuartal terakhir selalu berada di kisaran 6%–8%. Artinya, kita tidak hanya punya 100 responden. Misalkan ada 6 kuartal data, total 600 responden, dengan 42 orang di antaranya adalah user (7%):
wilson(42, 600)
#      bawah       atas
# 0.05220162 0.09326964
Rentangnya menyempit menjadi 5,2% – 9,3%. Inilah baseline yang jauh lebih bisa dipercaya.
Tapi perhatikan harganya. Dengan survey 100 orang per kuartal, mengumpulkan 600 responden butuh satu setengah tahun:
| Data gabungan | Kalau survey 100 orang per bulan | Survey 100 orang per kuartal |
|---|---|---|
| n = 300 | 3 bulan | 9 bulan |
| n = 600 | 6 bulan | 1,5 tahun |
| n = 1.200 | 1 tahun | 3 tahun |
Menggabungkan data selama 1,5 tahun berarti kita mengasumsikan persentase user tidak berubah selama 1,5 tahun. Padahal dalam rentang waktu itu bisa ada kompetitor baru, perubahan harga, atau perubahan distribusi. Jadi baseline dari survey kuartalan selalu punya dua sisi: makin panjang periodenya, makin sempit rentangnya, tapi makin besar risiko bahwa kondisi pasarnya sudah berubah.
Ada juga satu hal yang janggal. Kalau persentase user sebenarnya 7% dan setiap kuartal responden dipilih acak, peluang satu kuartal hasilnya jatuh di 6%–8% hanya sekitar 44%. Peluang enam kuartal berturut-turut semuanya jatuh di 6%–8%:
0,44 ^ 6 = 0,0075 → kurang dari 1%
Hasil yang terlalu stabil ini justru mencurigakan. Mungkin survey memakai panel yang sama setiap kuartal, ada pembobotan yang meredam variasi, atau kita memang sedang sangat beruntung. Sebelum menetapkan target apa pun, cek dulu metodologi survey-nya.
Ringkasan Bagian 1
| Keperluan | Yang dipakai |
|---|---|
| Merencanakan jumlah responden | MoE dengan p = 50%, atau p dari data historis |
Melaporkan hasil, terutama kalau p di bawah 20% atau di atas 80% |
Wilson dengan p hasil survey |
| Survey dengan pembobotan atau cluster | Wilson dengan n_efektif |
| Menetapkan baseline | Wilson dari data gabungan beberapa kuartal, dengan catatan soal stabilitas pasar |
Bagian 2: Kenapa Survey 100 Orang per Kuartal Tidak Bisa Jadi Rapor Tim Marketing?
Rentang perkiraan dari satu kuartal survey adalah 3,4% sampai 13,8%. Lebar sekali. Seberapa besar dampaknya kalau angka kuartalan ini dijadikan target tim marketing? Mari kita buat simulasi.
Simulasi 1: Empat “dunia paralel”
Bayangkan ada empat dunia paralel. Di keempat dunia ini, persentase user brand X tetap 7% selama 16 kuartal (4 tahun). Tidak ada kampanye. Tidak ada perubahan pasar. Tidak ada apa-apa. Setiap kuartal, kita melakukan survey 100 orang.
set.seed(2026)
dunia <- expand_grid(dunia = paste("Dunia", 1:4), kuartal = 1:16) |>
  mutate(hasil = rbinom(n(), size = 100, prob = 0.07) / 100)
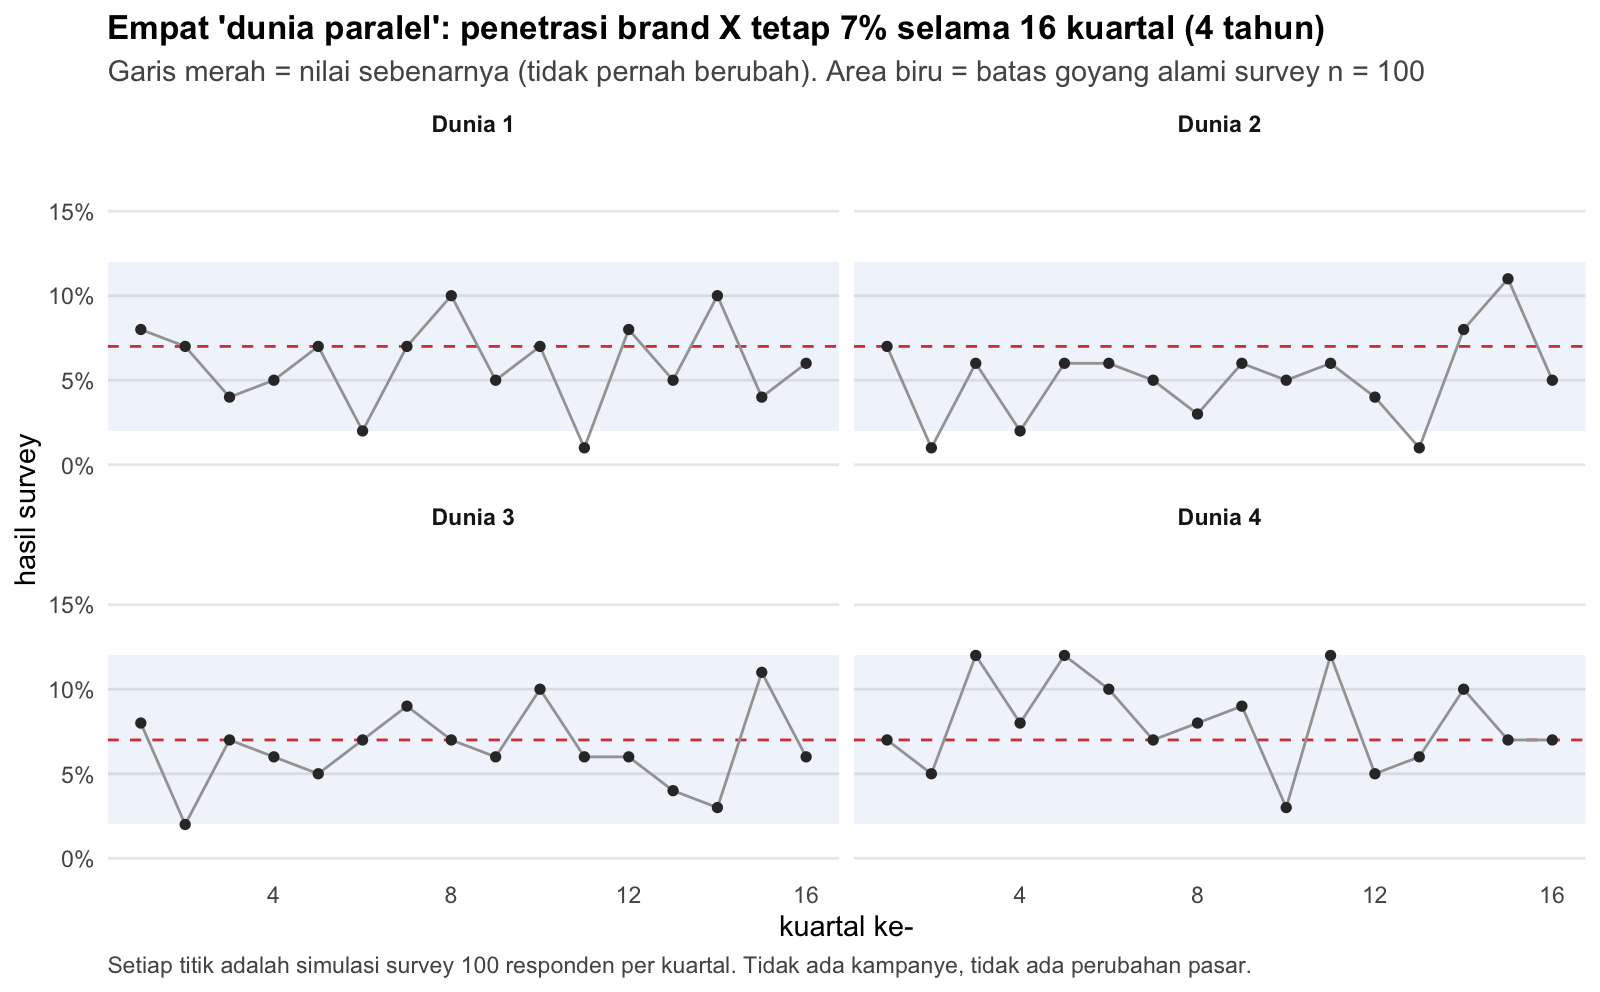
Hasil survey naik-turun dengan liar, dari 1% sampai 12%. Padahal tidak ada satu pun yang berubah!
Kalau grafik ini muncul di rapat kuartalan, saya yakin akan muncul banyak “cerita”:
- “Di Dunia 2, kuartal 13 masih 1%, dua kuartal kemudian naik ke 11%. Kampanye kita berhasil besar!”
- “Di Dunia 1, kuartal 11 anjlok ke 1%. Tim marketing ngapain aja?”
- “Di Dunia 3, angkanya turun terus dari 10% di kuartal 10 sampai 3% di kuartal 14. Setahun penuh trennya turun, ada yang salah nih.”
Semua cerita itu salah. Yang terjadi hanyalah kebetulan memilih responden. Area biru di grafik adalah batas goyang alami survey 100 orang, yaitu sekitar 2% sampai 12%. Selama hasil survey masih di area ini, kita tidak bisa menyimpulkan apa-apa.
Perhatikan contoh Dunia 3. Dengan survey kuartalan, “tren turun” yang sebenarnya hanya kebetulan itu bisa berlangsung setahun penuh. Cukup lama untuk memicu rapat darurat, pergantian strategi, bahkan pergantian orang.
Simulasi 2: Seberapa jauh hasil survey bisa “melompat”?
Yang biasanya dilaporkan bukan hanya angka kuartal ini, tapi juga selisihnya dengan kuartal lalu. Mari kita simulasikan 100.000 pasang kuartal dengan persentase user tetap 7%:
selisih <- rbinom(1e5, 100, 0.07) - rbinom(1e5, 100, 0.07)
mean(abs(selisih) >= 5)
# sekitar 0.21 (sedikit berbeda setiap kali dijalankan)
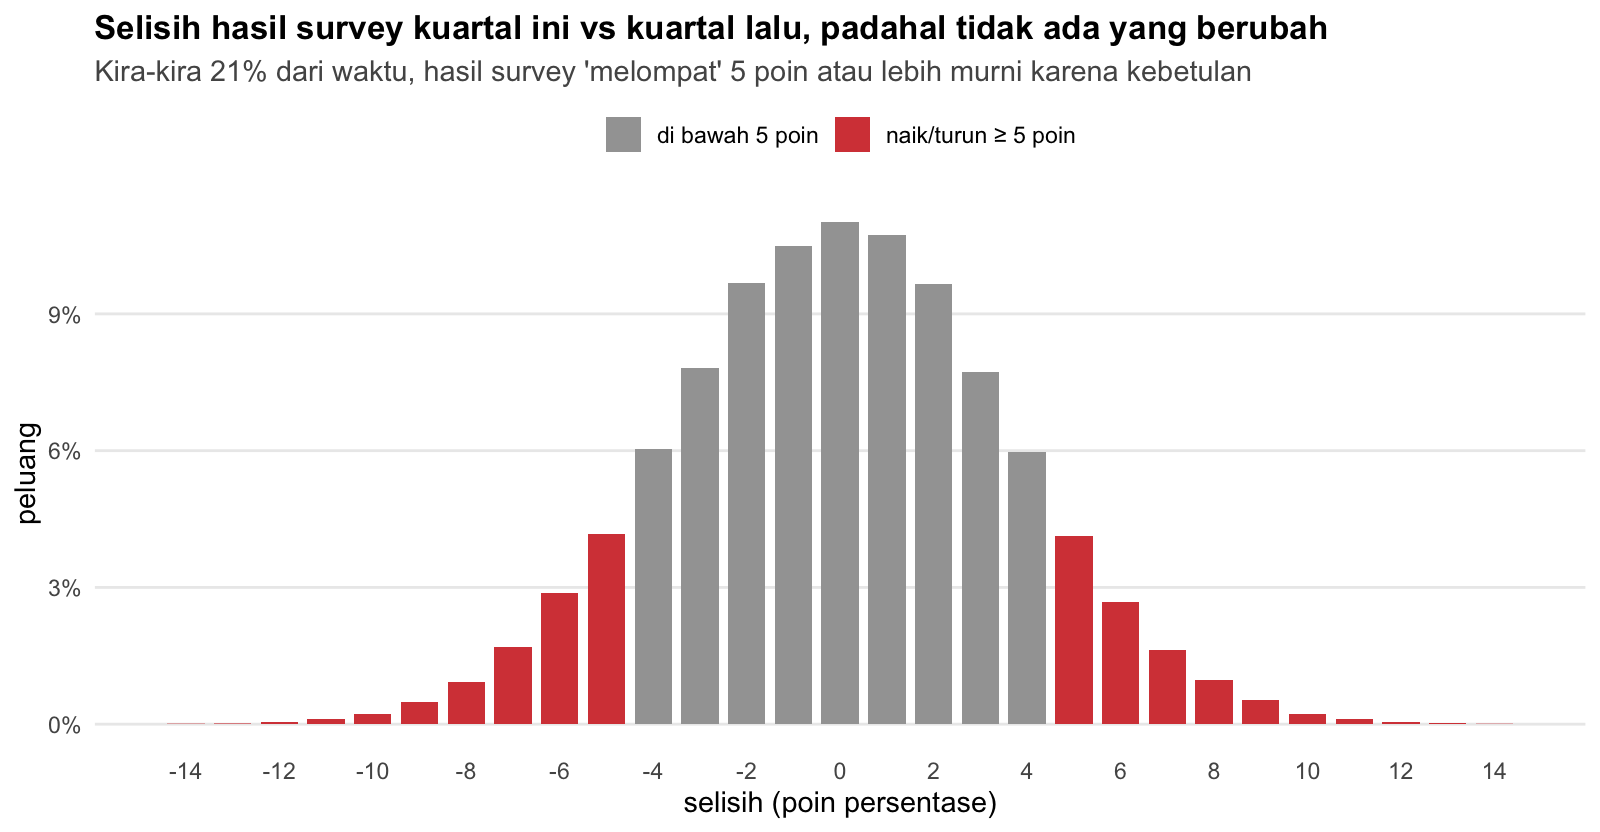
Sekitar 21% dari waktu (kira-kira satu dari lima kuartal), hasil survey “melompat” 5 poin atau lebih. Selisih sampai ±7 poin pun masih tergolong wajar.
Bandingkan dengan kemampuan tim marketing. Persentase user adalah metrik yang bergerak lambat. Konsumen perlu mendengar brand-nya, mencoba, lalu membeli ulang. Kampanye yang bagus pun biasanya hanya menggeser persentase user sekitar 1 sampai 3 poin per kuartal.
| Besarnya | |
|---|---|
| Sinyal (efek kerja tim marketing dalam satu kuartal yang realistis) | ~1–3 poin |
| Noise (naik-turun survey karena kebetulan) | ~±7 poin |
Sinyalnya 2 sampai 7 kali lebih kecil dari noise. Ibarat mencoba mendengar bisikan di tengah konser musik rock.
Simulasi 3: Peluang mencapai target
Misalkan target kuartal depan ditetapkan 10%. Berapa peluang hasil survey menyentuh target tersebut?
# peluang hasil survey >= 10 orang dari 100
1 - pbinom(9, size = 100, prob = 0.07)   # tim diam saja
# [1] 0.162
1 - pbinom(9, size = 100, prob = 0.10)   # tim berhasil menaikkan ke 10%
# [1] 0.549
1 - pbinom(9, size = 100, prob = 0.12)   # tim sangat berhasil
# [1] 0.774
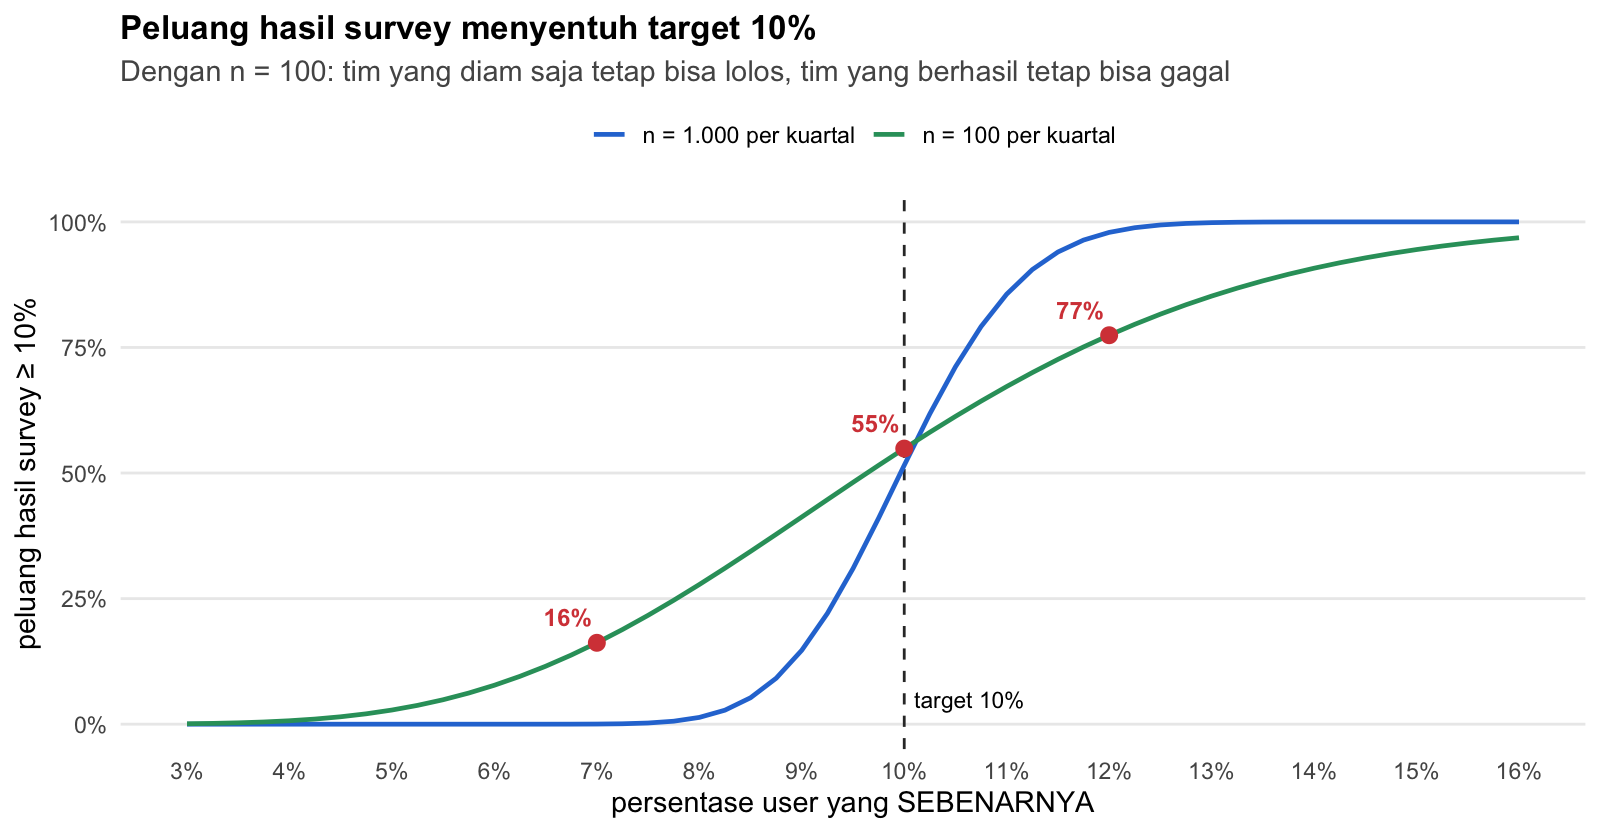
| Persentase user yang SEBENARNYA | Peluang survey menunjukkan ≥ 10% | Artinya |
|---|---|---|
| 7% (tim tidak menghasilkan apa-apa) | 16% | Tim yang diam saja tetap bisa “lolos target” |
| 10% (tim berhasil menaikkan 3 poin) | 55% | Tim yang berhasil, hampir separuh waktunya tetap dinilai “gagal” |
| 12% (tim sangat berhasil) | 77% | Tim yang sangat berhasil pun masih bisa “gagal” 1 dari 4 kali |
Dengan n = 100, penilaian kinerja tim tidak jauh berbeda dengan melempar koin. Bandingkan dengan garis hijau (n = 1.000) yang jauh lebih curam: dengan responden yang lebih banyak, survey jauh lebih bisa membedakan tim yang berhasil dengan yang tidak.
Simulasi 4: Kampanye yang berhasil, tapi tidak terlihat
Sekarang kita balik skenarionya. Tim marketing menjalankan kampanye yang benar-benar berhasil selama dua kuartal (kuartal 5 dan 6). Persentase user naik dari 7% ke 9%, lalu bertahan di 9%.
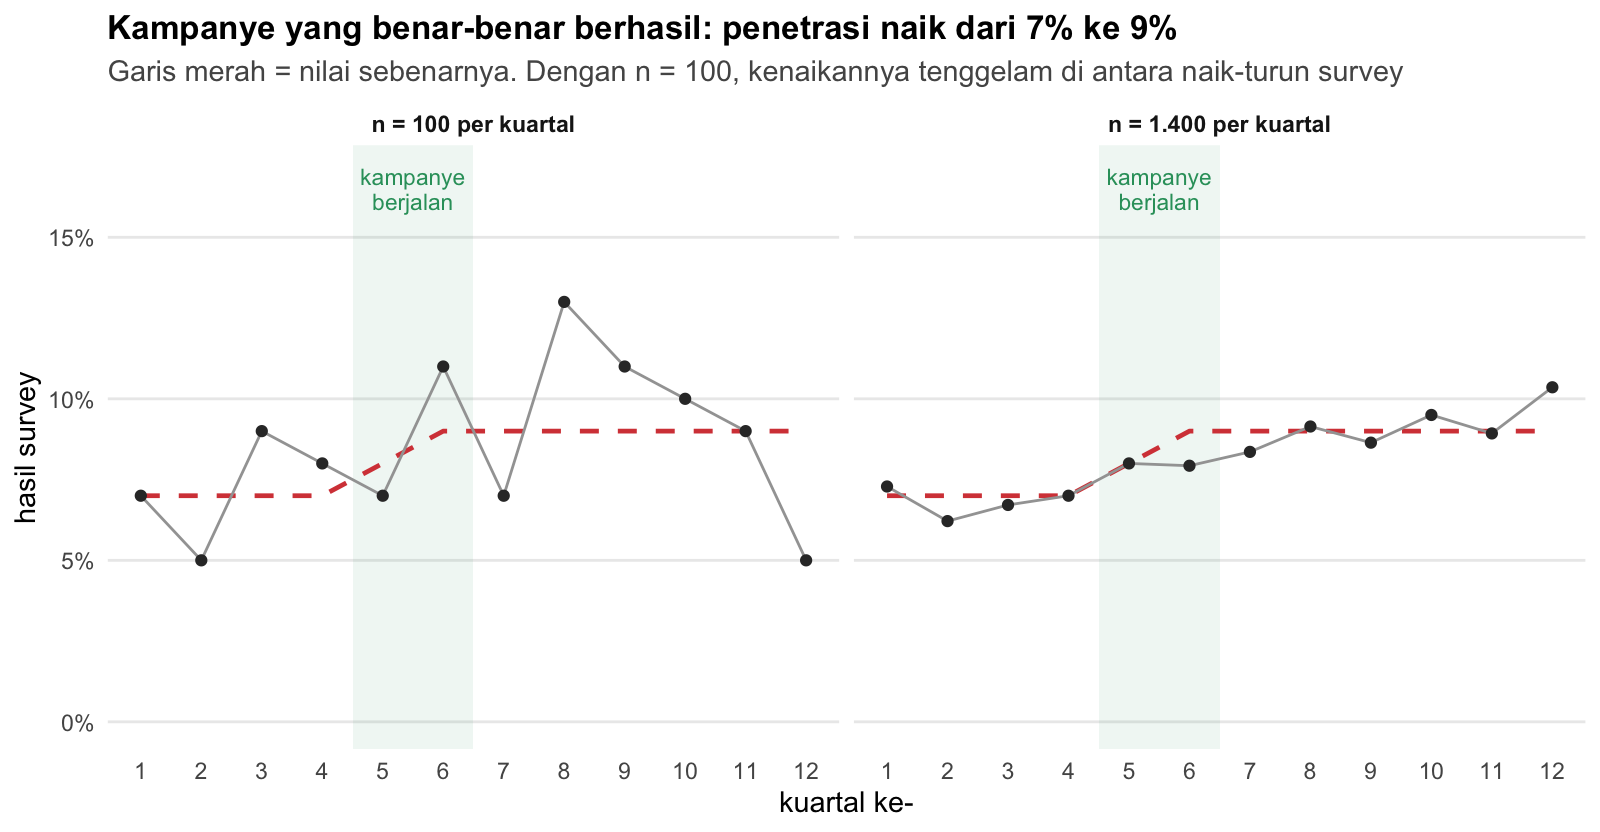
Di panel kiri (n = 100), cerita yang muncul dari survey sangat membingungkan:
- Kuartal 6, hasil survey melonjak ke 11%: “Kampanye berhasil!”
- Kuartal 7, hasil survey turun ke 7%: “Efek kampanye sudah habis.”
- Kuartal 12, hasil survey anjlok ke 5%: “Kita kembali ke titik awal, bahkan lebih buruk.”
Padahal nilai sebenarnya (garis merah) stabil di 9% sejak kuartal 6. Di panel kanan (n = 1.400 per kuartal), kenaikannya terlihat jelas mengikuti garis merah.
Simulasi 5: Teguran yang “seolah-olah” manjur
Ini efek yang paling berbahaya dalam praktik. Namanya regression to the mean (kembali ke rata-rata).
- Suatu kuartal, hasil survey kebetulan rendah (misalnya 4% atau kurang).
- Tim marketing ditegur dan diminta “bekerja lebih giat”.
- Kuartal berikutnya, hasil survey naik.
- Kesimpulan manajemen: “Tuh kan, kalau ditegur langsung kerja!”
Padahal persentase user sebenarnya tetap 7% dari awal sampai akhir.
set.seed(3)
kuartal_ini   <- rbinom(2e5, 100, 0.07)
kuartal_depan <- rbinom(2e5, 100, 0.07)
buruk <- kuartal_ini <= 4
mean(kuartal_depan[buruk] > kuartal_ini[buruk])
# [1] 0.8839218
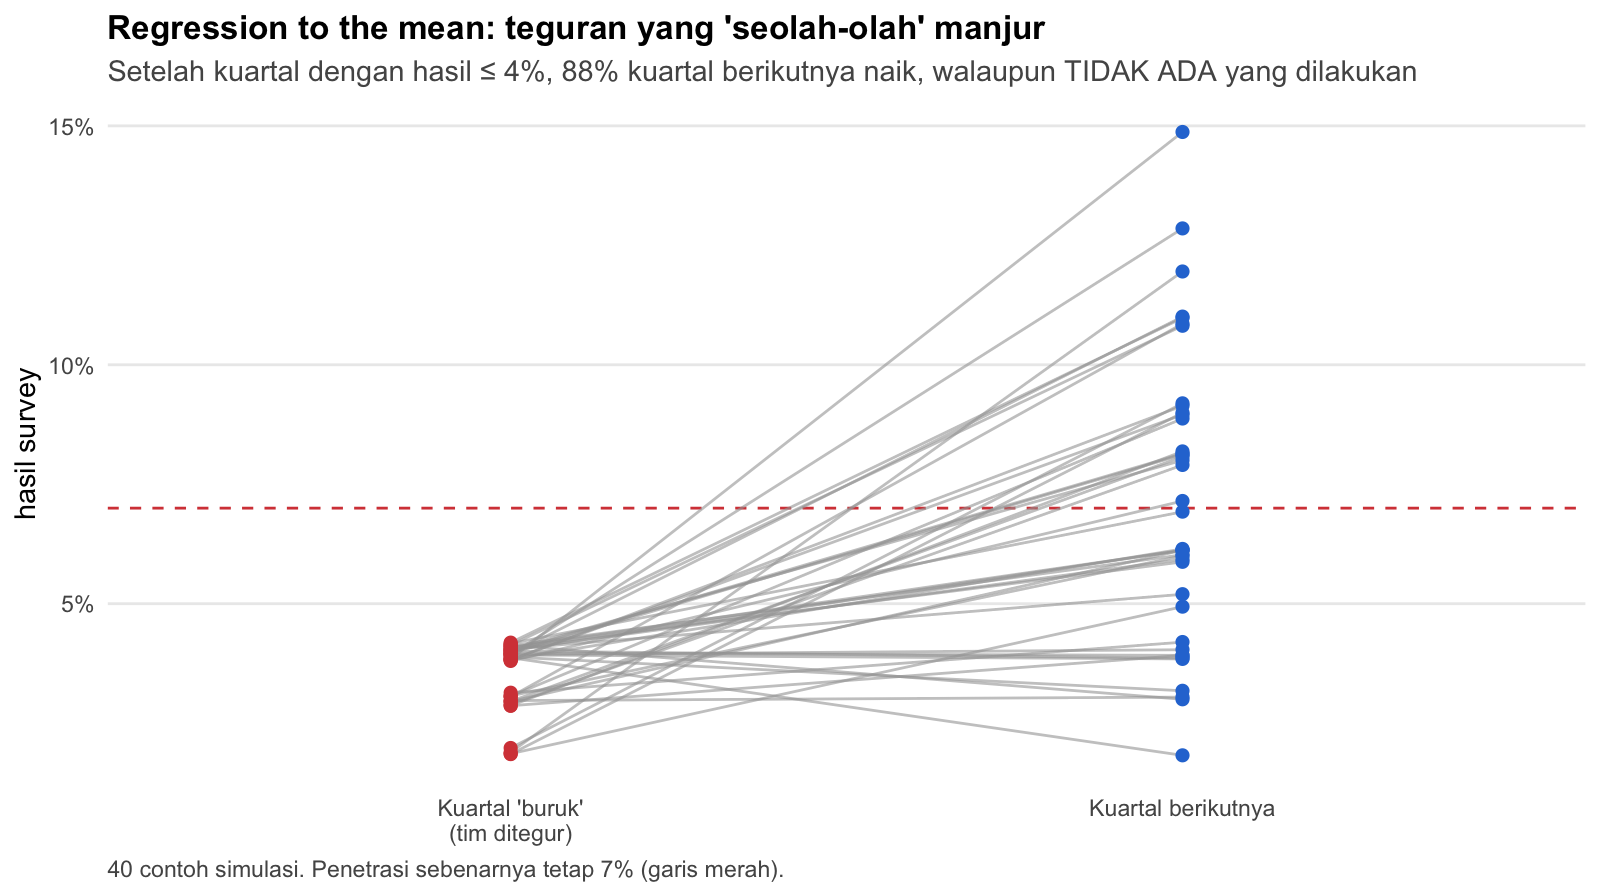
Setelah kuartal yang “buruk”, 88% kuartal berikutnya akan naik dengan sendirinya. Tanpa teguran, tanpa kerja ekstra. Hal sebaliknya juga terjadi: kuartal yang kebetulan tinggi diberi apresiasi, lalu kuartal berikutnya turun dan tim dianggap “lengah”.
Dengan survey kuartalan, kejadian seperti ini memang lebih jarang terjadi dibandingkan survey bulanan. Tapi setiap kejadiannya lebih mahal, karena keputusan yang diambil per kuartal biasanya menyangkut anggaran yang lebih besar dan bertahan lebih lama. Akibatnya:
- Organisasi belajar hal yang salah. Kita percaya teguran itu manjur dan apresiasi membuat tim lengah, padahal keduanya tidak ada hubungannya.
- Penghargaan dan hukuman dibagikan secara acak. Tim yang sebenarnya bagus bisa demotivasi.
- Keputusan anggaran jadi keliru. Kampanye yang berhasil bisa dihentikan hanya karena survey kuartal itu kebetulan rendah.
Simulasi 6: Berapa responden yang sebenarnya dibutuhkan?
Kemampuan survey untuk “melihat” perubahan yang nyata disebut power. Standar yang umum dipakai adalah 80%: kalau perubahannya benar-benar terjadi, survey bisa mendeteksinya minimal 8 dari 10 kali.
Misalkan tim berhasil menaikkan persentase user dari 7% ke 9% (+2 poin). Ada dua cara mengevaluasinya: dibandingkan dengan baseline gabungan yang sudah stabil, atau dibandingkan dengan kuartal lalu (dua angka yang sama-sama belum pasti).
# dibandingkan baseline yang sudah stabil
pw1 <- function(n, p0 = 0.07, p1 = 0.09)
  pnorm((p1 - p0 - 1.96 * sqrt(p0 * (1 - p0) / n)) / sqrt(p1 * (1 - p1) / n))

# dibandingkan kuartal lalu
pw2 <- function(n, p0 = 0.07, p1 = 0.09) {
  pb <- (p0 + p1) / 2
  pnorm((p1 - p0 - 1.96 * sqrt(2 * pb * (1 - pb) / n)) /
          sqrt((p0 * (1 - p0) + p1 * (1 - p1)) / n))
}

pw1(100); pw2(100)
# [1] 0.1471828
# [1] 0.07497723
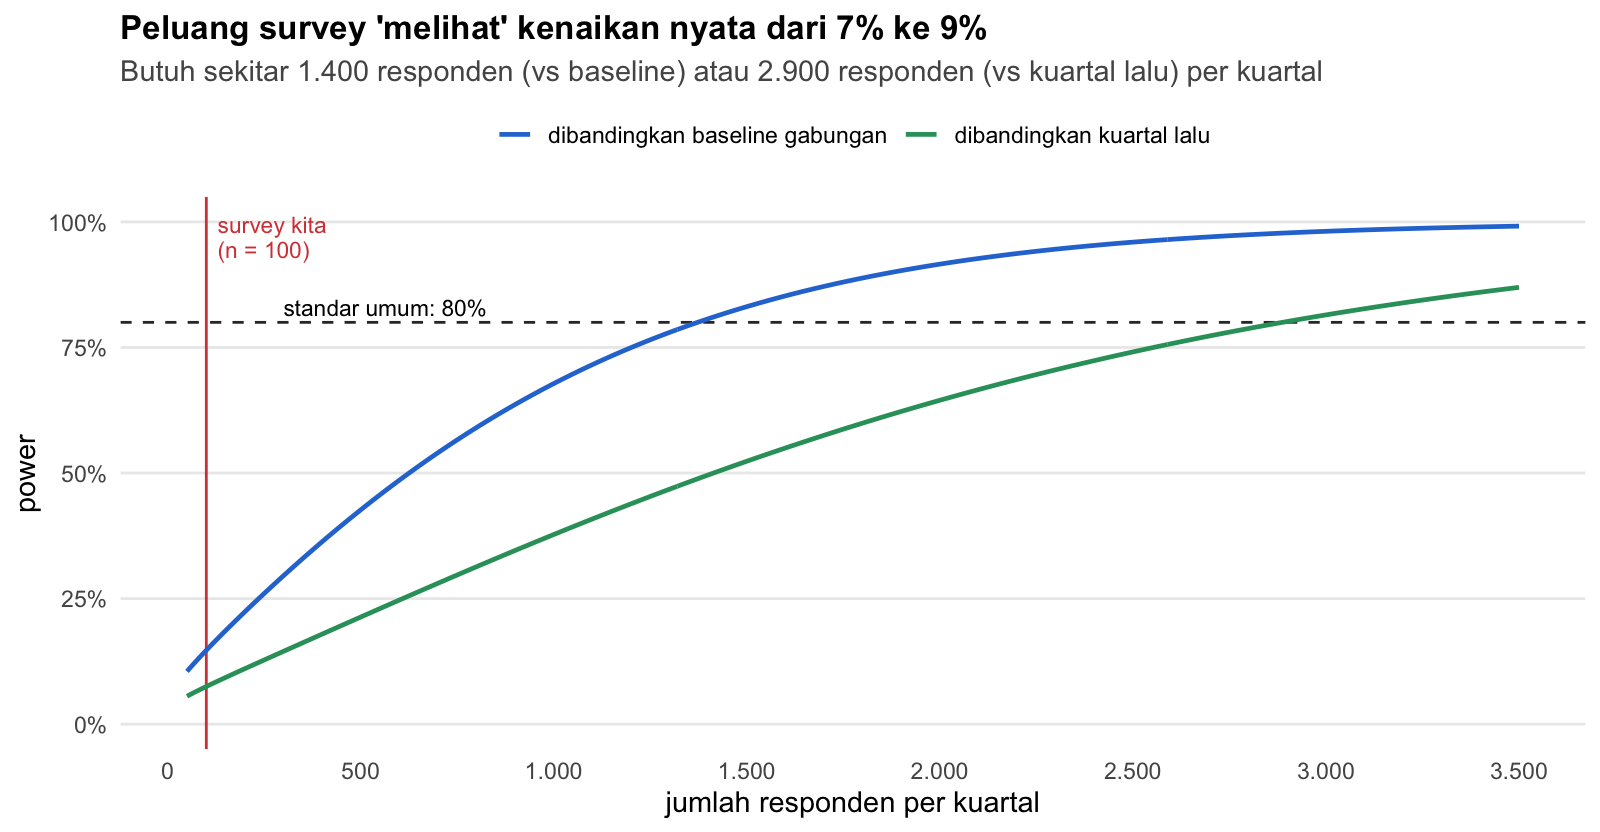
Dengan 100 responden, peluang survey mendeteksi kenaikan yang benar-benar terjadi hanya sekitar 15% (vs baseline) atau 7% (vs kuartal lalu). Untuk mencapai power 80%, butuh sekitar 1.400 responden per kuartal (vs baseline) atau 2.900 responden per kuartal (vs kuartal lalu).
Bagaimana kalau kita tidak menambah responden, tapi memperpanjang periode evaluasi? Dengan 100 responden per kuartal:
| Periode evaluasi | Total responden | MoE (±) | Power untuk +2 poin | Power untuk +3 poin | Kenaikan minimal yang bisa dideteksi (vs baseline) |
|---|---|---|---|---|---|
| 1 kuartal | 100 | 5,0 poin | 15% | 25% | +8,0 poin (7% → 15%) |
| 1 semester | 200 | 3,5 poin | 22% | 40% | +5,5 poin |
| 1 tahun | 400 | 2,5 poin | 36% | 63% | +3,8 poin |
| 1,5 tahun | 600 | 2,0 poin | 49% | 78% | +3,1 poin |
Bahkan dengan data setahun penuh, kenaikan +3 poin baru terdeteksi sekitar 6 dari 10 kali. Dengan satu kuartal saja, persentase user harus lebih dari dua kali lipat (7% menjadi 15%) agar terdeteksi dengan meyakinkan. Target yang tidak masuk akal untuk satu kuartal.
Masalah tambahan
- Alarm palsu tetap menumpuk. Kalau setiap kuartal kita menguji ada-tidaknya perubahan (tingkat kesalahan 5%), peluang minimal satu alarm palsu dalam setahun adalah
1 - 0,95^4 = 19%. Dalam tiga tahun (12 kuartal), peluangnya naik menjadi 46%. - Design effect. Dengan kuota atau cluster, 100 responden mungkin hanya setara 50–80 responden acak.
- Bukan hanya tim marketing yang mempengaruhi angka. Kompetitor, harga, distribusi, musim, bahkan bulan puasa ikut menggerakkan persentase user. Dalam satu kuartal, semua faktor ini ikut bercampur. Survey tidak bisa memisahkan kontribusi masing-masing.
Ringkasan Bagian 2
Survey 100 orang per kuartal tidak bisa membedakan tim yang bekerja keras dengan tim yang sedang beruntung. Ini bukan masalah cara menghitung, tapi masalah jumlah informasi di dalam datanya. Satu kuartal dengan 100 responden memberi informasi yang sama persis dengan satu bulan dengan 100 responden. Bedanya, kita harus menunggu tiga kali lebih lama untuk mendapatkannya.
Bagian 3: Bagaimana dengan Pendekatan Bayesian?
Di pekerjaan saya sehari-hari, saya pernah menghadapi masalah yang persis sama: menghitung target pencapaian riset untuk kuartal berikutnya. Datanya survey kuartalan dengan sekitar 100 responden per kuartal, dan ada puluhan indikator yang harus diberi target (trial, loyal, future intention, persepsi, dan lain-lain).
Saat itu saya memakai pendekatan Bayesian. Datanya tentu tidak bisa saya tampilkan di sini, jadi saya terapkan metode yang sama persis ke data simulasi brand X. Bagi rekan-rekan yang belum familiar dengan Bayesian dan distribusi Beta, silakan baca dulu tulisan saya Mengenal Analisa Bayesian yang Hasilnya Lebih Holistik.
Idenya: keyakinan yang diperbarui setiap kuartal
Pendekatannya bernama sequential Bayesian updating dengan model Beta-Binomial. Cara kerjanya mirip dengan bagaimana kita mengenal seseorang:
- Awalnya kita tidak tahu apa-apa. Persentase user bisa berapa saja dari 0% sampai 100%, semuanya sama mungkinnya. Ini adalah prior
Beta(1, 1). - Kuartal pertama, data survey datang. Keyakinan diperbarui menjadi posterior.
- Kuartal berikutnya, posterior kuartal lalu menjadi prior kuartal ini. Data baru datang, keyakinan diperbarui lagi. Begitu seterusnya.
Untuk model Beta-Binomial, cara memperbaruinya sangat sederhana:
alpha_baru = alpha_lama + jumlah user kuartal ini
beta_baru  = beta_lama  + jumlah bukan user kuartal ini
sequential_update <- function(x, n, alpha0 = 1, beta0 = 1) {
  alpha <- alpha0 + cumsum(x)
  beta  <- beta0  + cumsum(n - x)
  data.frame(kuartal = seq_along(x),
             rerata  = alpha / (alpha + beta),
             bawah   = qbeta(0.025, alpha, beta),
             atas    = qbeta(0.975, alpha, beta),
             alpha, beta)
}

set.seed(5)
x <- rbinom(8, 100, 0.07)    # 8 kuartal (2 tahun) survey brand X
seq_x <- sequential_update(x, rep(100, 8))
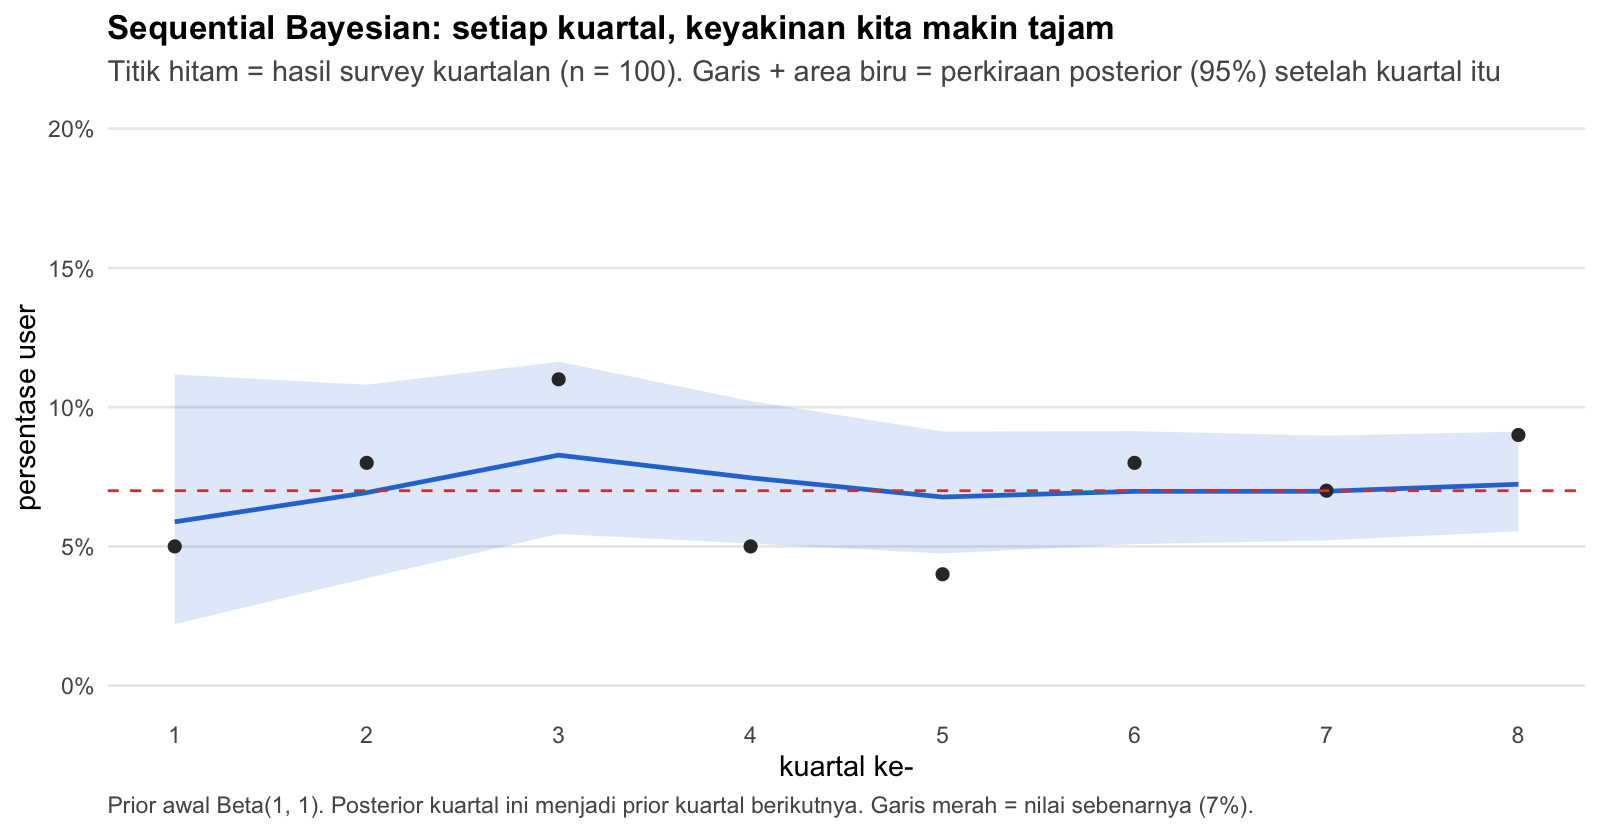
Area biru (rentang keyakinan 95%) menyempit setiap kuartal. Di kuartal pertama rentangnya 2,2% – 11,2%. Setelah 8 kuartal (2 tahun), tinggal 5,5% – 9,1%, dengan posterior Beta(58, 744) dan rata-rata 7,2%.
Rentang ini mirip sekali dengan interval Wilson dari data gabungan di Bagian 1. Wajar, karena sequential updating dengan prior Beta(1, 1) pada dasarnya sama dengan menggabungkan semua data. Bayesian dan Wilson sampai pada kesimpulan serupa lewat jalan yang berbeda. Perhatikan juga bahwa untuk sampai ke sini, dibutuhkan dua tahun data.
Dua jenis forecast: populasi vs hasil survey
Ini bagian yang menurut saya paling penting dari pekerjaan saya tersebut. Dari posterior kuartal ke-8, ada dua jenis forecast untuk kuartal ke-9:
| Jenis forecast | Pertanyaan yang dijawab | Cara menghitung |
|---|---|---|
| Theta | “Berapa persentase user brand X di populasi?” | Ambil sampel dari posterior Beta(alpha, beta) |
| Prediktif | “Berapa angka yang akan keluar dari survey 100 orang kuartal depan?” | Ambil sampel theta, lalu simulasikan survey 100 orang dari setiap theta |
Memakai analogi timbangan dari tulisan Angkanya Turun: theta adalah berat badan kita yang sebenarnya, sedangkan prediktif adalah angka yang akan muncul di timbangan besok pagi, yang ikut dipengaruhi jaket dan posisi berdiri.
forecast_berikutnya <- function(alpha, beta, n_next, sampel = 50000) {
  theta     <- rbeta(sampel, alpha, beta)
  prediktif <- rbinom(sampel, n_next, theta) / n_next
  list(theta = theta, prediktif = prediktif)
}

fc <- forecast_berikutnya(58, 744, n_next = 100)
quantile(fc$theta,     c(.1, .9))   # 6,1% - 8,4%
quantile(fc$prediktif, c(.1, .9))   # 4%   - 11%
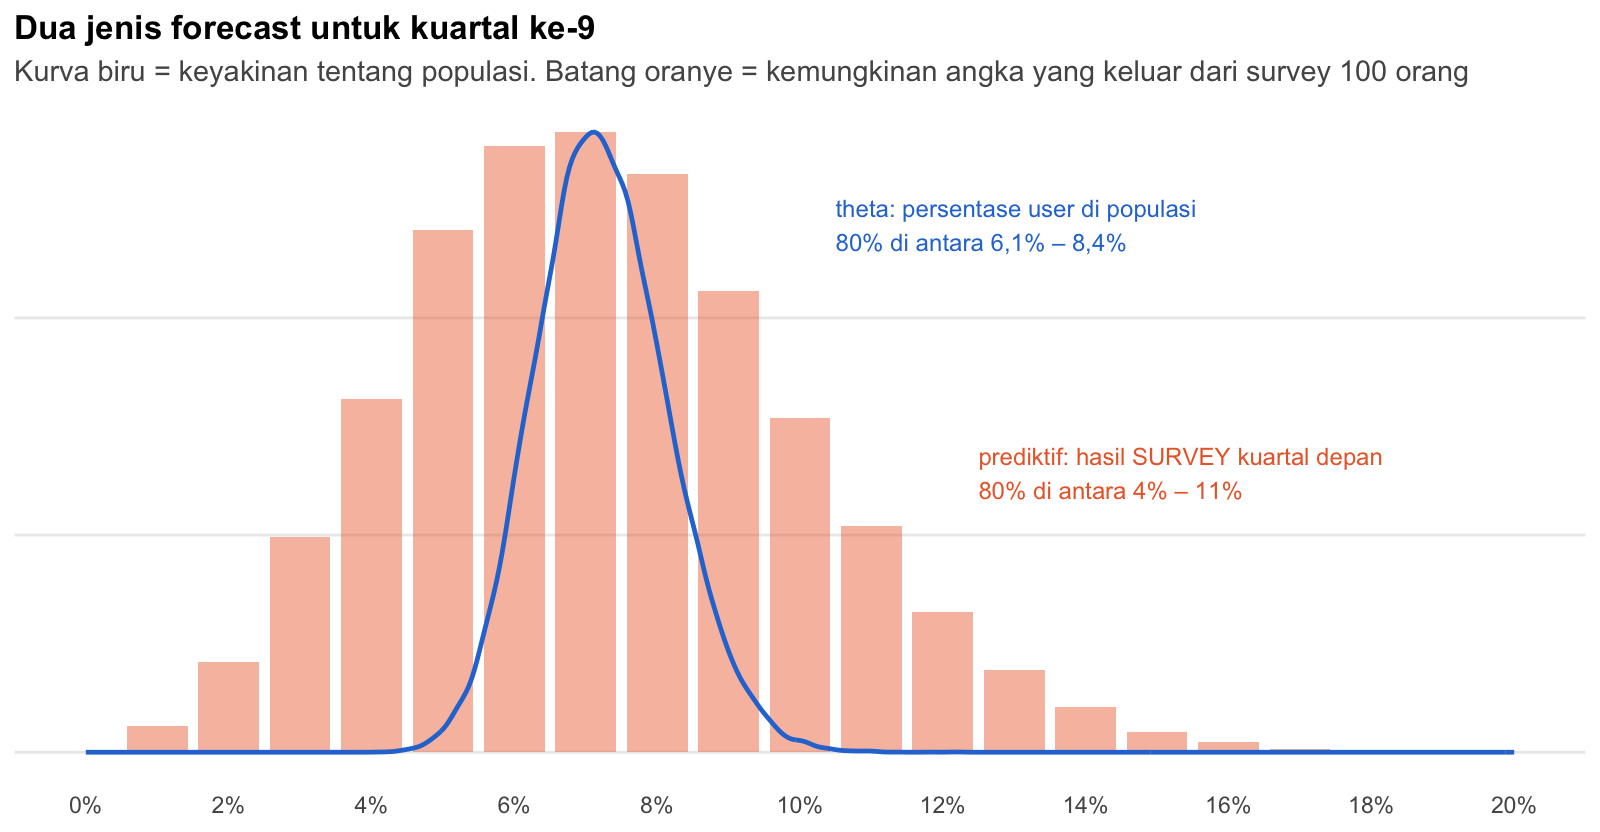
- Theta (kurva biru): 80% di antara 6,1% – 8,4%. Sempit, karena sudah ada 800 responden dari 8 kuartal.
- Prediktif (batang oranye): 80% di antara 4% – 11%. Lebar, karena survey kuartal depan hanya 100 orang, dan seluruh noise dari Bagian 2 ikut masuk ke sini.
Kesalahan yang sangat menggoda adalah memakai rentang theta untuk menetapkan target survey kuartal depan: “Target kuartal depan minimal 6,1%, karena itu batas bawah perkiraan kita.” Kedengarannya masuk akal, bukan?
Backtest: interval mana yang jujur?
Caranya: pakai data 8 kuartal untuk membuat forecast, lalu cek apakah hasil survey kuartal ke-9 benar-benar masuk ke rentang forecast. Proses ini diulang 2.000 kali.
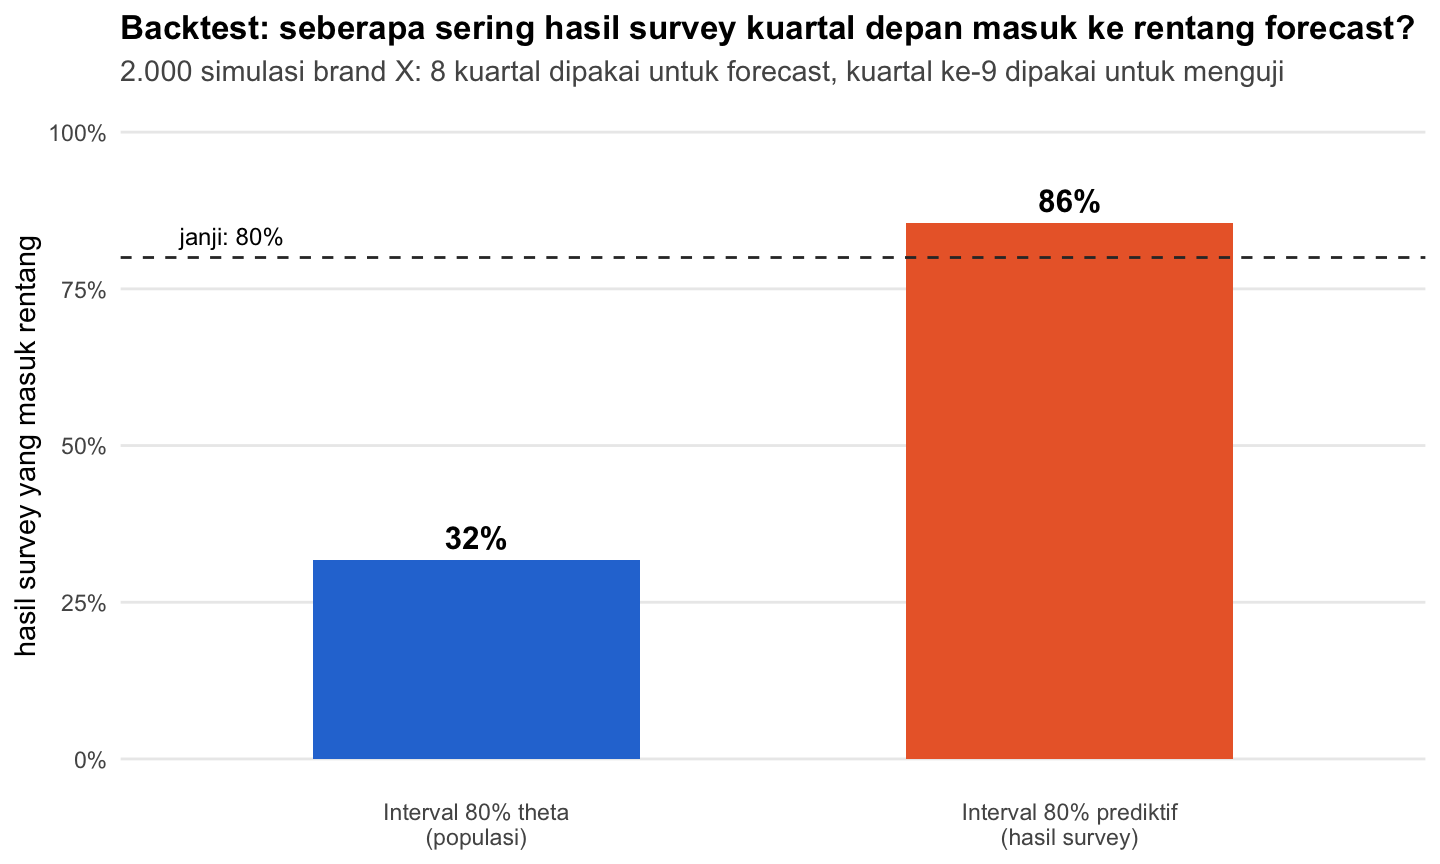
- Interval 80% theta hanya memuat 32% hasil survey berikutnya. Kalau dipakai sebagai target, 2 dari 3 kuartal hasil survey akan berada di luar rentang, padahal tidak terjadi apa-apa.
- Interval 80% prediktif memuat 86% hasil survey berikutnya. Sesuai janjinya (sedikit di atas 80% karena hasil survey selalu bilangan bulat).
Hasil simulasi ini hampir sama persis dengan yang saya temukan di pekerjaan saya dengan data riset kuartalan yang sebenarnya. Dari 190 kali uji one-step-ahead di puluhan indikator, interval 80% theta hanya memuat 33% hasil aktual, sedangkan interval 80% prediktif memuat 80%, dan interval 95% prediktif memuat 96%.
Kalau yang dinilai adalah angka hasil survey, rentang target harus diambil dari distribusi prediktif, bukan dari distribusi theta.
Menetapkan target dengan cara Bayesian
Cara 1: rentang prediktif sebagai “zona normal”. Rentang prediktif 80% (4% – 11%) adalah angka-angka yang wajar muncul kalau tidak ada yang berubah. Hasil survey di dalam zona ini belum bisa disimpulkan apa-apa. Baru kalau hasilnya di atas 11%, ada indikasi kenaikan (peluangnya hanya sekitar 10% kalau kondisi tetap sama).
Kalau target kuartal depan dipatok 10%, peluang hasil survey menyentuh target itu tanpa ada perubahan apa pun sekitar 20%:
mean(fc$prediktif >= 0.10)
# sekitar 0.20
Angka ini lebih besar dari 16% di Bagian 2, karena di sini ketidakpastian tentang baseline ikut dihitung (rata-rata posterior brand X di simulasi ini 7,2%, bukan tepat 7%).
Cara 2: target dinyatakan sebagai peluang. Ini kelebihan utama Bayesian: kita bisa langsung menjawab “seberapa yakin kita bahwa persentase user sudah naik?” Bandingkan posterior periode kampanye dengan posterior baseline Beta(58, 744):
Target tercapai jika peluang persentase user selama periode kampanye lebih tinggi dari baseline minimal 90%.
base <- rbeta(1e5, 58, 744)
# contoh: hasil survey 10% selama 2 kuartal berturut-turut (20 dari 200)
kampanye <- rbeta(1e5, 1 + 20, 1 + 180)
mean(kampanye > base)
# sekitar 0.92
| Hasil survey selama kampanye | 1 kuartal (n = 100) | 2 kuartal (n = 200) | 4 kuartal (n = 400) |
|---|---|---|---|
| 9% | 79% | 84% | 88% |
| 10% | 87% | 92% | 96% |
| 12% | 96% | 99% | > 99% |
Dengan ambang 90%, tim dianggap berhasil kalau hasil survey satu kuartal mencapai sekitar 12%, atau dua kuartal berturut-turut (satu semester) konsisten di sekitar 10%. Kalau hasilnya hanya 9%, bahkan setahun penuh pun belum cukup untuk mencapai keyakinan 90%.
Perhatikan: posterior kampanye di atas dihitung terpisah (mulai dari Beta(1, 1) lagi), bukan disambung ke posterior 8 kuartal sebelumnya. Alasannya ada di bagian berikut.
Jebakan: Bayesian yang “terlalu setia” pada masa lalu
Sequential updating di atas punya asumsi tersembunyi: persentase user dianggap tidak pernah berubah. Kuartal pertama dan kuartal terakhir diberi bobot yang sama. Dengan data kuartalan, asumsi ini jauh lebih berat, karena 8 kuartal berarti kita menganggap pasar tidak berubah selama dua tahun. Bagaimana kalau kampanye benar-benar berhasil?
Selama 8 kuartal pertama, persentase user sebenarnya 7%. Mulai kuartal ke-9, naik menjadi 10%.
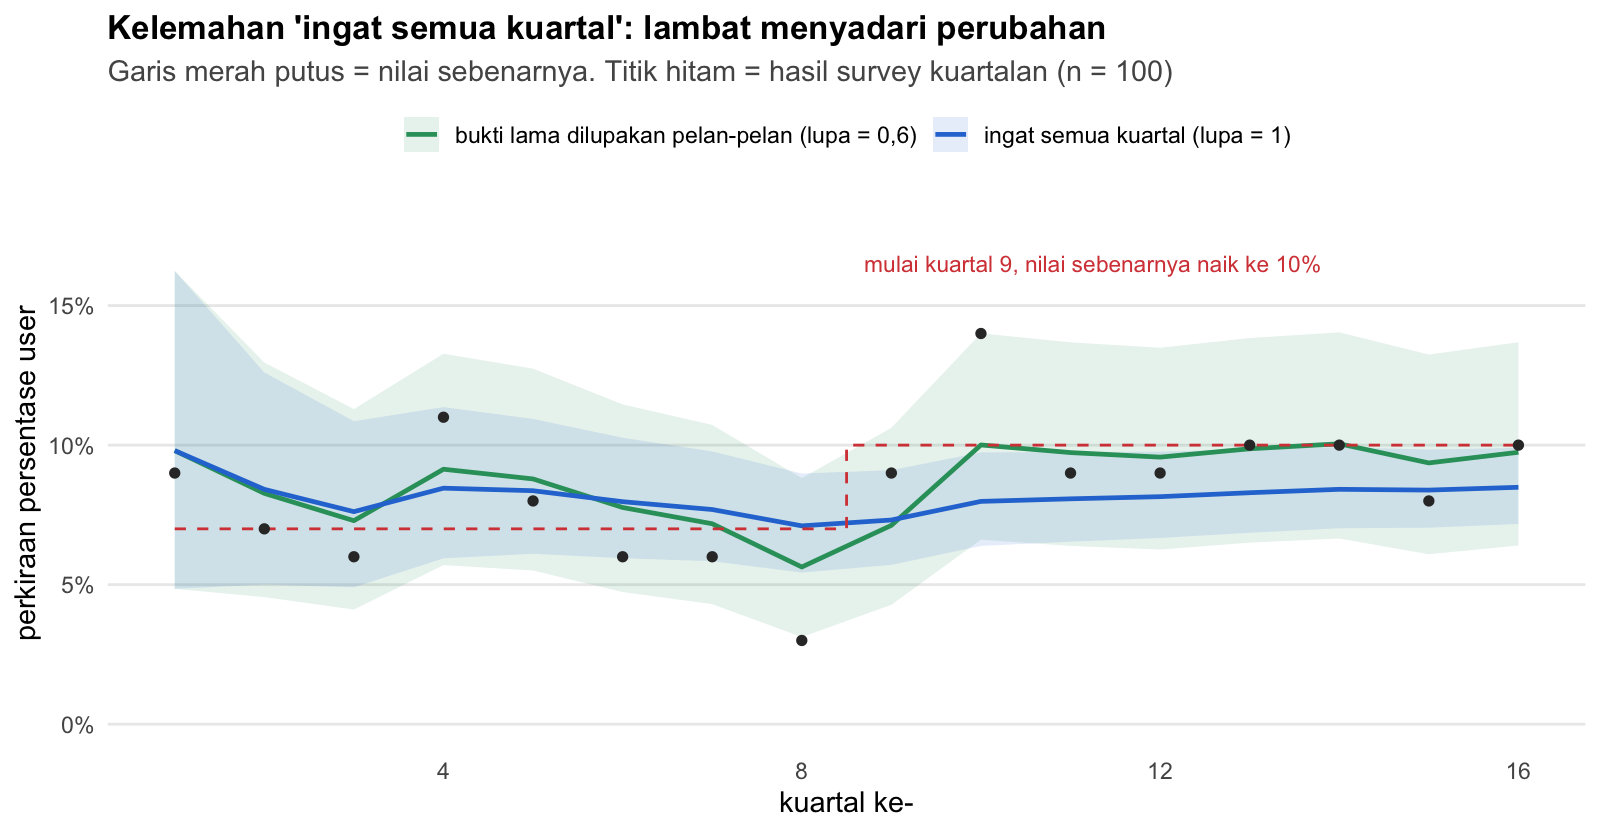
Garis biru (“ingat semua kuartal”) bergerak sangat lambat. Setelah dua tahun berada di level baru (kuartal 16), perkiraannya baru 8,5% dengan rentang 95% di 7,2% – 9,9%. Rentang ini bahkan tidak memuat nilai sebenarnya (10%)! Kalau metode ini dipakai untuk menilai kampanye, kampanye yang berhasil akan terlihat jauh lebih kecil dari kenyataannya, selama bertahun-tahun.
Solusinya adalah “melupakan” bukti lama secara perlahan (discounting atau forgetting factor):
alpha_baru = 1 + lupa x (alpha_lama - 1) + jumlah user kuartal ini
beta_baru  = 1 + lupa x (beta_lama  - 1) + jumlah bukan user kuartal ini
Dengan lupa = 0,6 (garis hijau), bukti dari dua kuartal lalu hanya “bernilai” sekitar sepertiganya (0,6² = 0,36). Perkiraan kuartal ke-16 menjadi 9,7% dengan rentang 6,4% – 13,7%. Hanya butuh dua kuartal untuk menangkap perubahan, dan rentangnya memuat nilai sebenarnya. Harganya: rentangnya jadi jauh lebih lebar, karena kita sengaja “membuang” sebagian informasi yang memang sudah sedikit. Tidak ada makan siang gratis.
Satu hal yang perlu diingat: nilai lupa tergantung panjang periode. Faktor lupa 0,8 per bulan setara dengan sekitar 0,5 per kuartal (0,8³ ≈ 0,51). Jadi untuk data kuartalan, nilai lupa harus jauh lebih kecil dibandingkan untuk data bulanan.
Satu catatan lagi, dan ini juga catatan untuk diri saya sendiri. Saat menghitung peluang naik dari satu kuartal ke kuartal berikutnya, jangan membandingkan dua posterior kumulatif (misalnya posterior s.d. kuartal 7 vs posterior s.d. kuartal 8). Keduanya berbagi data yang sama sebanyak 7 kuartal, sehingga peluang naiknya cenderung berada di sekitar 50%, bahkan ketika ada perubahan nyata. Untuk menilai perubahan, bandingkan periode yang tidak tumpang-tindih, seperti di Cara 2 tadi.
Ringkasan Bagian 3
| Aspek | Frequentist (Bagian 1–2) | Bayesian (Bagian 3) |
|---|---|---|
| Rentang baseline | Interval Wilson dari data gabungan | Posterior dari sequential updating |
| Rentang hasil survey kuartal depan | Batas goyang / control chart | Distribusi prediktif |
| Cara menilai kampanye | Uji hipotesis, p-value, power | Peluang persentase user naik dibandingkan baseline |
| Kelebihan | Standar, mudah diaudit | Bahasanya intuitif (“92% yakin naik”), ketidakpastian baseline ikut dihitung |
| Jebakan | Memakai MoE 50% untuk membaca hasil | Memakai rentang theta untuk menilai hasil survey; terlalu setia pada data lama |
| Kebutuhan responden | Tetap besar | Tetap besar |
Baris terakhir tabel ini adalah kuncinya. Dengan Bayesian pun, kesimpulannya sejalan dengan Bagian 2: kenaikan baru terdeteksi kalau hasilnya sekitar 12% dalam satu kuartal, atau 10% selama satu semester.
Bayesian adalah cara membaca data, bukan sumber data. Survey 100 orang mengandung informasi dalam jumlah tertentu. Wilson, control chart, dan Bayesian hanya bisa membacanya dengan jujur. Tidak satu pun bisa menambahnya.
Jadi kalau Bayesian bukan jawabannya, lalu apa?
Bagian 4: Kerangka Tiga Pertanyaan
Kebingungan di kasus brand X muncul karena satu kalimat permintaan bisnis ternyata berisi tiga pertanyaan yang berbeda. Masing-masing butuh alat ukur dan cara menetapkan target yang berbeda.
Pertanyaan 1: Apakah brand kita tumbuh?
Ini pertanyaan monitoring. Yang ingin diketahui adalah kesehatan brand di pasar secara keseluruhan, terlepas dari siapa yang menyebabkannya.
Alat ukur: survey tracking kuartalan yang sudah ada. Survey inilah alat yang tepat, asalkan dibaca dengan cara yang benar:
- Periode evaluasinya per semester atau per tahun. Hasil satu kuartal dipakai sebagai pemantauan, bukan sebagai vonis.
- Pakai control chart. Buat “batas goyang” di sekitar baseline. Hasil di dalam batas dianggap noise. Baru dianggap sinyal kalau keluar batas, atau beberapa kuartal berturut-turut berada di sisi yang sama.
Berikut simulasinya. Selama 10 kuartal pertama, persentase user sebenarnya 7%. Mulai kuartal ke-11, naik menjadi 10%.
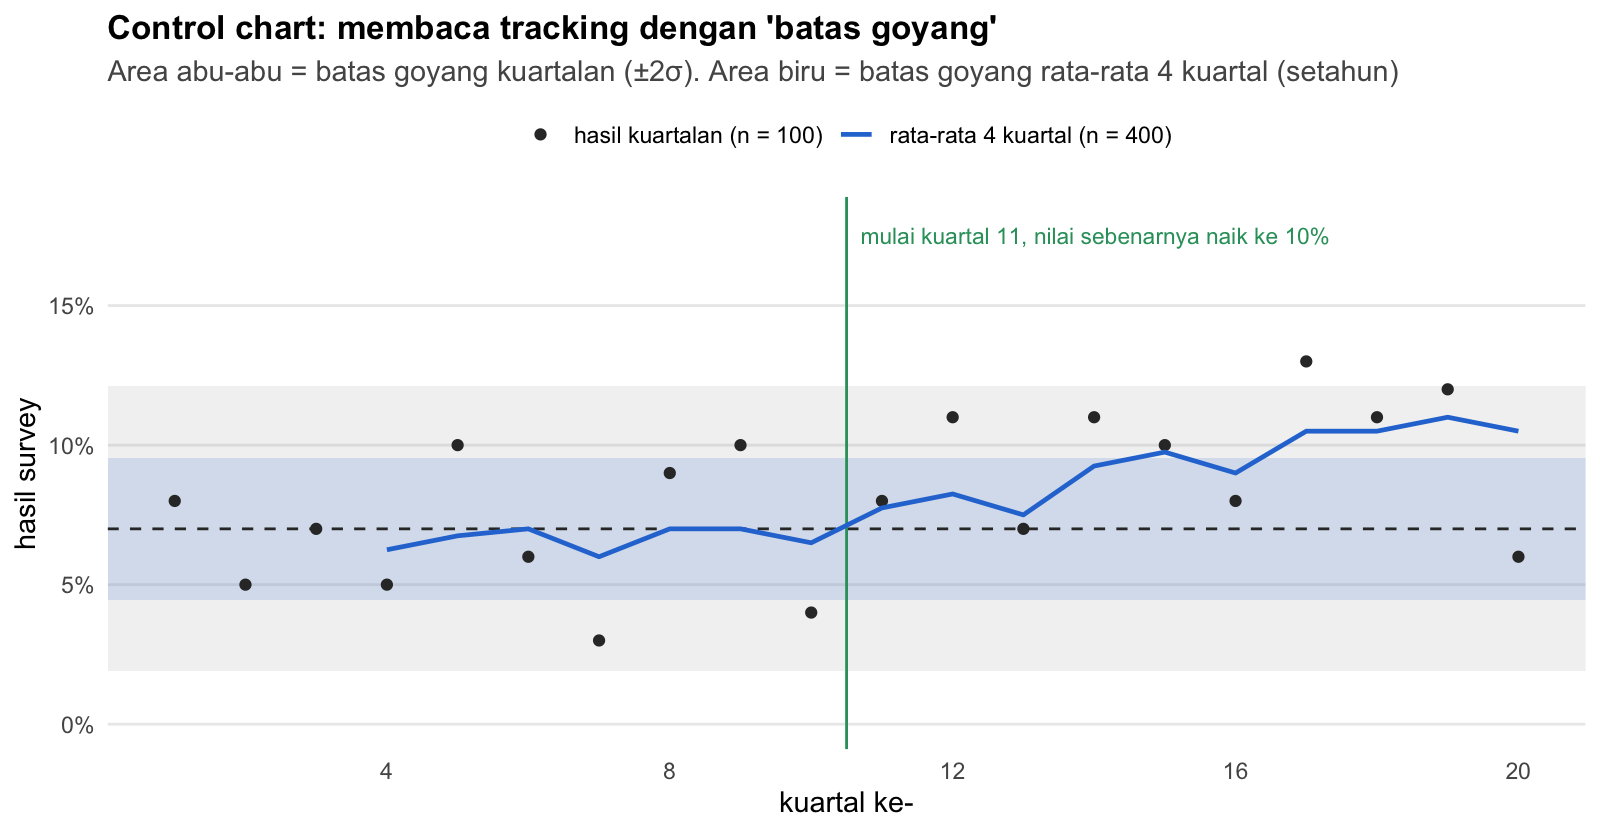
- Titik hitam (kuartalan, n = 100) naik-turun liar. Di 10 kuartal pertama saja, ada kuartal yang 3% dan ada yang 10%. Batas goyang kuartalan (area abu-abu) sekitar 2%–12%. Setelah kuartal ke-11, hanya satu titik (kuartal 17) yang keluar dari area abu-abu.
- Garis biru (rata-rata 4 kuartal, n = 400) jauh lebih tenang, dengan batas goyang lebih sempit sekitar 4,4%–9,6% (area biru). Di 10 kuartal pertama, garis biru tetap di dalam area biru. Garis biru baru menyentuh batas atas di kuartal 15, lalu konsisten di atasnya mulai kuartal 17.
Coba perhatikan berapa lama waktu yang dibutuhkan. Kenaikan terjadi di kuartal 11, tapi baru terlihat meyakinkan di kuartal 17. Itu satu setengah tahun setelah perubahan terjadi. Ini satu hasil simulasi, tapi polanya umum: dengan 100 responden per kuartal, survey adalah alat untuk melihat tren tahunan, bukan untuk bereaksi cepat. Ide yang sama pernah saya tulis dengan istilah lampu lalu lintas di tulisan Angkanya Turun.
Cara menetapkan target: pakai rumusan Bayesian dari Bagian 3.
“Pada akhir semester, kami minimal 90% yakin persentase user lebih tinggi dari baseline.”
Ditambah zona normal dari distribusi prediktif, supaya hasil kuartalan yang masih wajar tidak dibahas sebagai keberhasilan atau kegagalan.
Kalau butuh lebih tajam: di sinilah Bayesian benar-benar bisa memberi nilai tambah, yaitu lewat model hierarkis. Kalau ada puluhan indikator atau banyak segmen, masing-masing bisa “meminjam” informasi dari yang lain (partial pooling). Prinsipnya sama dengan yang pernah saya tulis di Bagaimana Jika Responden Survey di Kota Tertentu Sangat Sedikit?. Bisa juga memakai prior yang informatif dari pengalaman kampanye-kampanye sebelumnya.
Pertanyaan 2: Apakah tim marketing bekerja dengan baik?
Ini pertanyaan kinerja. Yang ingin dinilai adalah apakah tim menjalankan tugasnya, kuartal demi kuartal.
Alat ukur: KPI yang dikendalikan langsung oleh tim dan datanya besar sehingga tidak banyak noise:
| Jenis KPI | Contoh |
|---|---|
| Eksekusi | Kampanye berjalan sesuai jadwal dan anggaran, materi sesuai brief |
| Jangkauan | Reach, impression, frekuensi iklan, jumlah sampling produk yang dibagikan |
| Distribusi | Jumlah toko yang menjual, ketersediaan produk di rak |
| Respons awal | Jumlah trial, traffic, penukaran voucher |
| Hasil bisnis | Penjualan (dari data internal, bukan survey) |
Cara menetapkan target: target angka bulanan atau kuartalan biasa. Karena datanya berasal dari ribuan transaksi atau jutaan impression, naik-turunnya karena kebetulan sangat kecil. Metode frequentist atau Bayesian akan memberi hasil yang hampir sama.
Survey penetrasi tidak dipakai sebagai rapor kuartalan. Survey ini tetap dilaporkan, tapi sebagai konfirmasi tren (Pertanyaan 1).
Pertanyaan 3: Apakah kampanye kita yang menyebabkan kenaikan?
Ini pertanyaan atribusi (sebab-akibat). Inilah pertanyaan yang sebenarnya ada di balik kalimat “kalau target tidak tercapai, tim harus bekerja lebih giat”. Kalimat itu mengasumsikan bahwa naik-turunnya angka disebabkan oleh tim.
Survey tracking tidak bisa menjawab pertanyaan ini, berapa pun jumlah respondennya. Persentase user bisa naik karena kompetitor kehabisan stok, bisa turun karena bulan puasa. Survey hanya melihat hasil akhirnya. Dengan survey kuartalan, masalah ini bahkan lebih parah: dalam satu kuartal, efek kampanye bercampur dengan semua kejadian lain selama tiga bulan.
Alat ukur: eksperimen. Bandingkan area yang mendapat kampanye (test) dengan area yang tidak (control). Karena kedua area sama-sama mengalami musim, kompetitor, dan harga yang sama, selisih di antara keduanya adalah efek kampanye.
Kalau eksperimen penuh tidak memungkinkan, ada alternatifnya:
- Geo-lift: kampanye dijalankan di beberapa kota dulu, kota lain menjadi pembanding.
- Causal Impact (Bayesian structural time series): membangun “dunia paralel” tanpa kampanye dari data area pembanding, lalu membandingkannya dengan kenyataan. Metode ini pernah saya bahas di Apakah Penjualan Naik Karena Promosi atau Kebetulan Saja?. Menariknya, di sinilah pendekatan Bayesian paling bersinar.
Cara menetapkan target: target berupa besarnya efek kampanye dibandingkan kelompok pembanding. Misalnya: “area kampanye minimal 2 poin lebih tinggi dari area pembanding, dengan keyakinan 90%.” Jumlah responden per area dihitung dari tabel power di Bagian 2.
Dengan survey kuartalan n = 100, eksperimen bukan lagi sekadar “dianjurkan”. Eksperimen praktis wajib, karena tanpa itu survey hampir tidak bisa melihat efek kampanye dalam waktu yang berguna untuk mengambil keputusan.
Mana yang paling penting untuk diperbaiki?
Kalau harus memilih, ini urutan perbaikan dari dampak terbesar:
| Urutan | Perbaikan | Dampak |
|---|---|---|
| 1 | Desain: buat kelompok pembanding (test vs control) | Satu-satunya cara memisahkan efek kampanye dari faktor lain |
| 2 | Jumlah data: tambah responden per kuartal | Mengecilkan noise tanpa harus menunggu bertahun-tahun |
| 3 | KPI: nilai tim dari metrik yang mereka kendalikan | Penilaian jadi adil dan tidak ditentukan keberuntungan |
| 4 | Metode analisis: Wilson, control chart, atau Bayesian | Dampaknya paling kecil, tapi tetap penting agar tidak salah baca |
Ironisnya, perdebatan di kantor sering terjadi di urutan nomor 4 (“pakai frequentist atau Bayesian?”), padahal masalah terbesarnya ada di urutan nomor 1 sampai 3.
Bagian 5: Langkah Praktis untuk Brand X
Berdasarkan semua pembahasan di atas, berikut yang sebaiknya dilakukan untuk brand X.
Langkah 0: Cek metodologi survey. Hasil 6%–8% selama enam kuartal berturut-turut terlalu stabil untuk survey acak 100 orang (peluangnya kurang dari 1%). Pastikan dulu apakah survey memakai panel tetap atau pembobotan, karena ini mengubah semua perhitungan di bawah.
Langkah 1: Tetapkan baseline. Gabungkan data beberapa kuartal terakhir. Untuk brand X: 7% (interval Wilson 5,2% – 9,3%) dari 6 kuartal, atau versi Bayesian: posterior Beta(58, 744) dari 8 kuartal dengan rentang 95% 5,5% – 9,1%. Catat periode datanya, karena baseline ini mengasumsikan pasar stabil selama 1,5 sampai 2 tahun.
Langkah 2: Pisahkan tiga pertanyaan, lalu tetapkan target untuk masing-masing.
| Pertanyaan | Target untuk brand X | Dievaluasi |
|---|---|---|
| 1. Apakah brand tumbuh? | Minimal 90% yakin persentase user lebih tinggi dari baseline. Dalam praktiknya, rata-rata 2 kuartal sekitar 10% atau lebih | Per semester, dikonfirmasi per tahun |
| 2. Apakah tim bekerja dengan baik? | Target angka untuk KPI eksekusi, jangkauan, distribusi, trial, dan penjualan | Per bulan atau per kuartal |
| 3. Apakah kampanye menyebabkan kenaikan? | Area kampanye lebih tinggi dari area pembanding, dengan keyakinan minimal 90% | Per kampanye |
Langkah 3: Pantau hasil kuartalan tanpa menghakimi. Hasil survey kuartalan tetap dilaporkan bersama zona normal (prediktif 80%: 4% – 11%) dan control chart. Hasil di dalam zona normal tidak dibahas sebagai keberhasilan atau kegagalan. Ini sekaligus mencegah jebakan regression to the mean.
Langkah 4: Rancang kampanye berikutnya sebagai eksperimen. Sisakan beberapa area tanpa kampanye sebagai pembanding, supaya di akhir kampanye kita bisa menjawab Pertanyaan 3 dengan meyakinkan.
Langkah 5: Kalau penilaian per kuartal berbasis survey memang wajib, tidak ada jalan lain selain menaikkan jumlah responden. Minimal 300 per kuartal untuk melihat perubahan besar, dan 600 atau lebih per kuartal untuk mendeteksi kenaikan sekitar 3 poin (lihat tabel power di Bagian 2).
Dan satu hal yang tidak boleh dilakukan:
Jangan menilai kinerja tim dari satu angka survey 100 orang dalam satu kuartal.
Epilog
Limitasi
Sebelum menutup, saya rasa penting untuk jujur soal limitasi dari tulisan ini:
- Semua datanya simulasi. Brand X fiktif, dan simulasinya mengasumsikan responden dipilih secara acak sederhana setiap kuartal. Survey di dunia nyata sering memakai kuota, panel, atau pembobotan yang membuat noise-nya lebih besar (atau, seperti kasus 6%–8% tadi, justru lebih kecil secara mencurigakan).
- Angka efek kampanye (+1 sampai +3 poin per kuartal) adalah ilustrasi. Besarnya akan berbeda untuk setiap kategori produk, setiap brand, dan setiap jenis kampanye.
- Perhitungan power dan jumlah responden memakai pendekatan distribusi normal. Untuk proporsi kecil dan sampel kecil, hasil eksaknya bisa sedikit berbeda. Misalnya, power eksak untuk n = 100 (vs baseline) adalah sekitar 11%, bukan 15%. Kesimpulannya tetap sama.
- Control chart dan grafik Bayesian yang ditampilkan masing-masing adalah satu contoh simulasi. Kalau diulang dengan seed berbeda, gambarnya akan sedikit berbeda.
- Interval Wilson dan pendekatan Bayesian di sini hanya menangkap sampling error. Kesalahan dari kuesioner, wawancara, atau pemilihan responden tidak tercakup di dalamnya.
- Pendekatan Bayesian di sini memakai prior
Beta(1, 1)dan model Beta-Binomial paling sederhana. Nilai faktorlupa = 0,6saya pilih untuk ilustrasi. Di dunia nyata, nilainya sebaiknya dipilih lewat backtest, atau diganti dengan model yang secara eksplisit mengizinkan persentase user berubah dari waktu ke waktu (misalnya model state-space).
Kembali ke pertanyaan awal: “Bagaimana cara menentukan target yang benar?”
Jawabannya ternyata bukan soal mencari angka target yang pas, dan juga bukan soal memilih antara frequentist atau Bayesian. Jawabannya adalah memisahkan pertanyaan bisnisnya terlebih dahulu, lalu memastikan setiap pertanyaan diukur dengan alat yang sanggup menjawabnya. Survey 100 orang per kuartal adalah alat yang bagus untuk memantau kesehatan brand dalam jangka panjang, dari tahun ke tahun. Untuk menilai kerja keras tim kuartal demi kuartal, kita butuh KPI yang lebih dekat dengan pekerjaan mereka. Untuk membuktikan efek kampanye, kita butuh kelompok pembanding.
Sebelum menyuruh tim bekerja lebih giat, pastikan dulu alat ukur kita bisa membedakan kerja keras dengan keberuntungan.
if you find this article helpful, support this blog by clicking the ads.